Copilot może przyspieszyć analizę danych, tworzenie wizualizacji i pracę z modelem semantycznym. Nie zastępuje jednak uporządkowanych źródeł, prawidłowych relacji ani uzgodnionych definicji wskaźników. Jeżeli model zawiera kilka podobnych miar sprzedaży, techniczne nazwy kolumn i niejednoznaczne relacje, asystent AI otrzymuje ten sam problem, z którym wcześniej mierzyli się użytkownicy raportów. Różnica polega na tym, że odpowiedź wygenerowana w naturalnym języku może brzmieć przekonująco nawet wtedy, gdy została oparta na niewłaściwej metryce.
Dlatego przygotowanie danych do Copilota w Power BI powinno być traktowane jako praca nad jakością modelu, kontekstem biznesowym i zasadami korzystania z danych. Samo udostępnienie funkcji Copilot nie sprawi, że niespójny model stanie się jednoznaczny. Potrzebne są czytelne nazwy, zweryfikowane miary, kontrolowany zakres danych, odpowiednie uprawnienia oraz zestaw testów odpowiadających rzeczywistym pytaniom użytkowników.
W tym artykule wyjaśniamy, jak przygotować dane i model semantyczny Power BI do pracy z Copilotem, jak korzystać z funkcji Prep data for AI oraz jak ocenić gotowość rozwiązania przed udostępnieniem go pracownikom. Materiał koncentruje się na wdrożeniu i utrzymaniu jakości. Ogólne możliwości asystenta opisuje odrębny artykuł TTMS poświęcony AI i Copilotowi w Power BI.
1. Power BI gotowy na AI
Model gotowy na AI pozwala użytkownikowi zadawać pytania w języku biznesowym bez konieczności znajomości technicznych nazw tabel i kolumn. Nie oznacza to, że Copilot zna organizację lub sam odkryje wszystkie reguły obowiązujące w firmie. Potrafi korzystać z informacji udostępnionych przez model, jego metadane, konfigurację funkcji AI oraz kontekst raportu. Jakość tej warstwy wpływa na to, czy pytanie o „sprzedaż” zostanie powiązane z oficjalną miarą przychodu netto, wartością zamówień czy innym polem o podobnej nazwie.
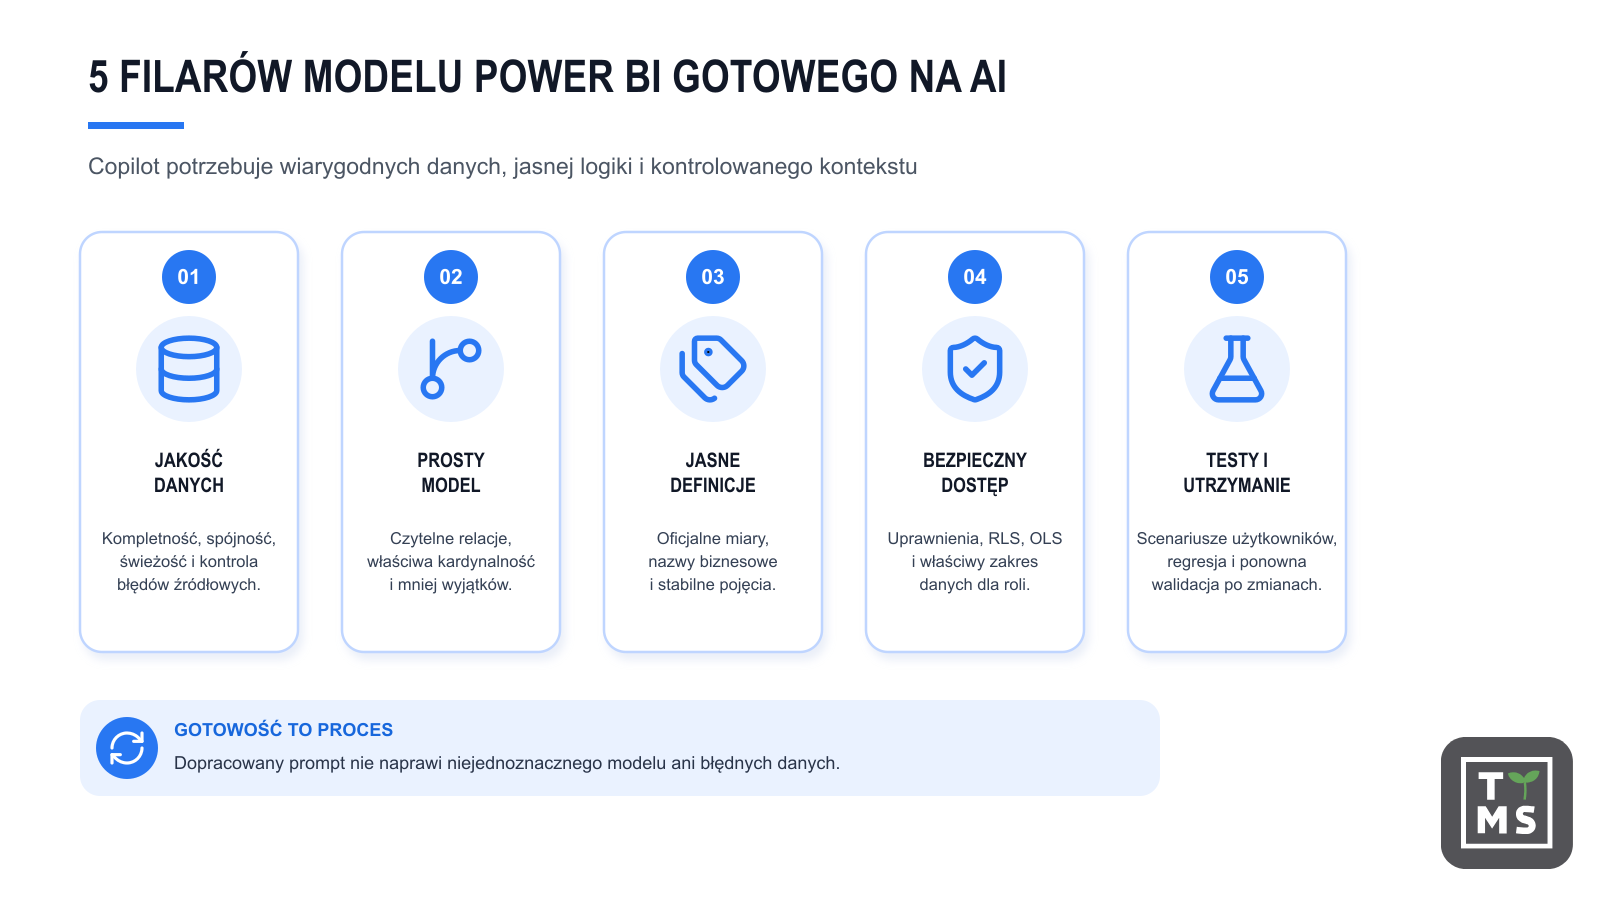
Gotowość modelu należy oceniać w pięciu obszarach:
- jakość i aktualność danych źródłowych;
- poprawność oraz prostota modelu semantycznego;
- jednoznaczność pojęć, nazw i miar biznesowych;
- bezpieczeństwo, uprawnienia i odpowiedzialność za dane;
- powtarzalny proces testowania odpowiedzi Copilota.
Jeżeli któryś z tych obszarów nie został przygotowany, samo dopracowywanie promptów przyniesie ograniczony efekt. Użytkownik może dokładniej sformułować pytanie, ale nadal nie wie, która z trzech miar marży jest oficjalna ani dlaczego jedna tabela używa daty zamówienia, a inna daty faktury.
2. Dlaczego model semantyczny decyduje o jakości odpowiedzi
Model semantyczny stanowi warstwę pomiędzy danymi źródłowymi a użytkownikiem raportu. Zawiera tabele, kolumny, miary, relacje, formaty, hierarchie i reguły bezpieczeństwa. Dla Copilota jest podstawowym źródłem informacji o tym, jak dane są zorganizowane i jak należy je interpretować.
Asystent może wykorzystać między innymi schemat modelu, relacje, właściwości obiektów, typy danych, formaty oraz wybrane metadane. Nie powinien jednak zgadywać definicji, które w organizacji mają szczególne znaczenie. Jeżeli „aktywny klient” oznacza klienta, który dokonał zakupu w ciągu ostatnich 90 dni, definicja powinna być zapisana w modelu i używana przez oficjalną miarę. Pozostawienie kilku możliwych interpretacji zwiększa ryzyko wyboru niewłaściwej.
2.1 Przykład niejednoznacznego modelu
Załóżmy, że w modelu znajdują się miary „Sales”, „Total Sales”, „Net Sales” i „Sales Adjusted”. Dla analityka, który zna projekt, różnice mogą być oczywiste. Użytkownik biznesowy i Copilot widzą natomiast cztery prawdopodobne odpowiedzi na pytanie „Jaka była sprzedaż w ubiegłym kwartale?”.
Naprawa nie polega jedynie na dopisaniu instrukcji, że Copilot ma wybierać jedną z miar. Najpierw warto ustalić oficjalną definicję, nadać jej czytelną nazwę, opisać sposób liczenia, ukryć pola techniczne i usunąć nieużywane obiekty. Instrukcja AI może następnie doprecyzować kontekst, ale nie powinna zastępować porządku w modelu.
3. Wymagania techniczne przed rozpoczęciem pracy
Przed przebudową modelu należy sprawdzić, czy środowisko spełnia aktualne wymagania Microsoftu. Dostępność Copilota zależy od ustawień dzierżawy, uprawnień, obszaru roboczego oraz przypisanej pojemności. Wymagania mogą różnić się między Power BI Desktop, usługą Power BI i poszczególnymi doświadczeniami Copilot.
Na dzień przygotowania artykułu dokumentacja Microsoft dotycząca wymagań Copilota w Power BI wskazuje między innymi na potrzebę włączenia odpowiedniego ustawienia dzierżawy oraz korzystania z obsługiwanej płatnej pojemności Fabric albo Power BI Premium. Autor modelu potrzebuje również właściwych uprawnień do obszaru roboczego i modelu semantycznego. Prep data for AI jest obecnie funkcją w wersji zapoznawczej. Przed jej wdrożeniem trzeba uwzględnić aktualne ograniczenia, w tym wymaganie włączenia Power BI Q&A oraz obsługiwane typy połączeń w Power BI Desktop.
| Obszar | Co trzeba sprawdzić | Dlaczego ma to znaczenie |
| Pojemność | Czy obszar roboczy korzysta z obsługiwanej płatnej pojemności Fabric lub Power BI Premium | Bez właściwej pojemności wybrane doświadczenia Copilot mogą być niedostępne |
| Ustawienia dzierżawy | Czy administrator włączył korzystanie z Copilota i funkcji opartych na Azure OpenAI dla odpowiednich grup | Dostęp powinien być nadany świadomie i zgodnie z polityką organizacji |
| Uprawnienia | Czy autor ma prawa do edycji modelu i publikacji w docelowym obszarze roboczym | Konfiguracja modelu wymaga uprawnień odpowiednich dla danego środowiska |
| Typ połączenia | Czy sposób połączenia jest obsługiwany przez używaną funkcję w Desktop lub usłudze | Zakres obsługi różni się między narzędziami i może się zmieniać |
| Power BI Q&A | Czy funkcja Q&A jest włączona dla modelu | Jest to obecnie jedno z wymagań funkcji Prep data for AI |
Wymagań licencyjnych i funkcjonalnych nie należy utrwalać w wewnętrznej instrukcji raz na zawsze. Microsoft rozwija Copilota i zmienia dostępność poszczególnych doświadczeń. Przed wdrożeniem warto sprawdzić aktualną dokumentację oraz ustawienia własnej dzierżawy.
4. Przygotowanie danych do Copilota w Power BI
Dane powinny być wiarygodne jeszcze przed załadowaniem ich do modelu. Copilot nie naprawi brakujących rekordów, błędnego mapowania klientów ani niespójnych kodów walut. Może natomiast wykorzystać te dane do wygenerowania odpowiedzi, która ukryje problem pod poprawnie brzmiącym opisem.
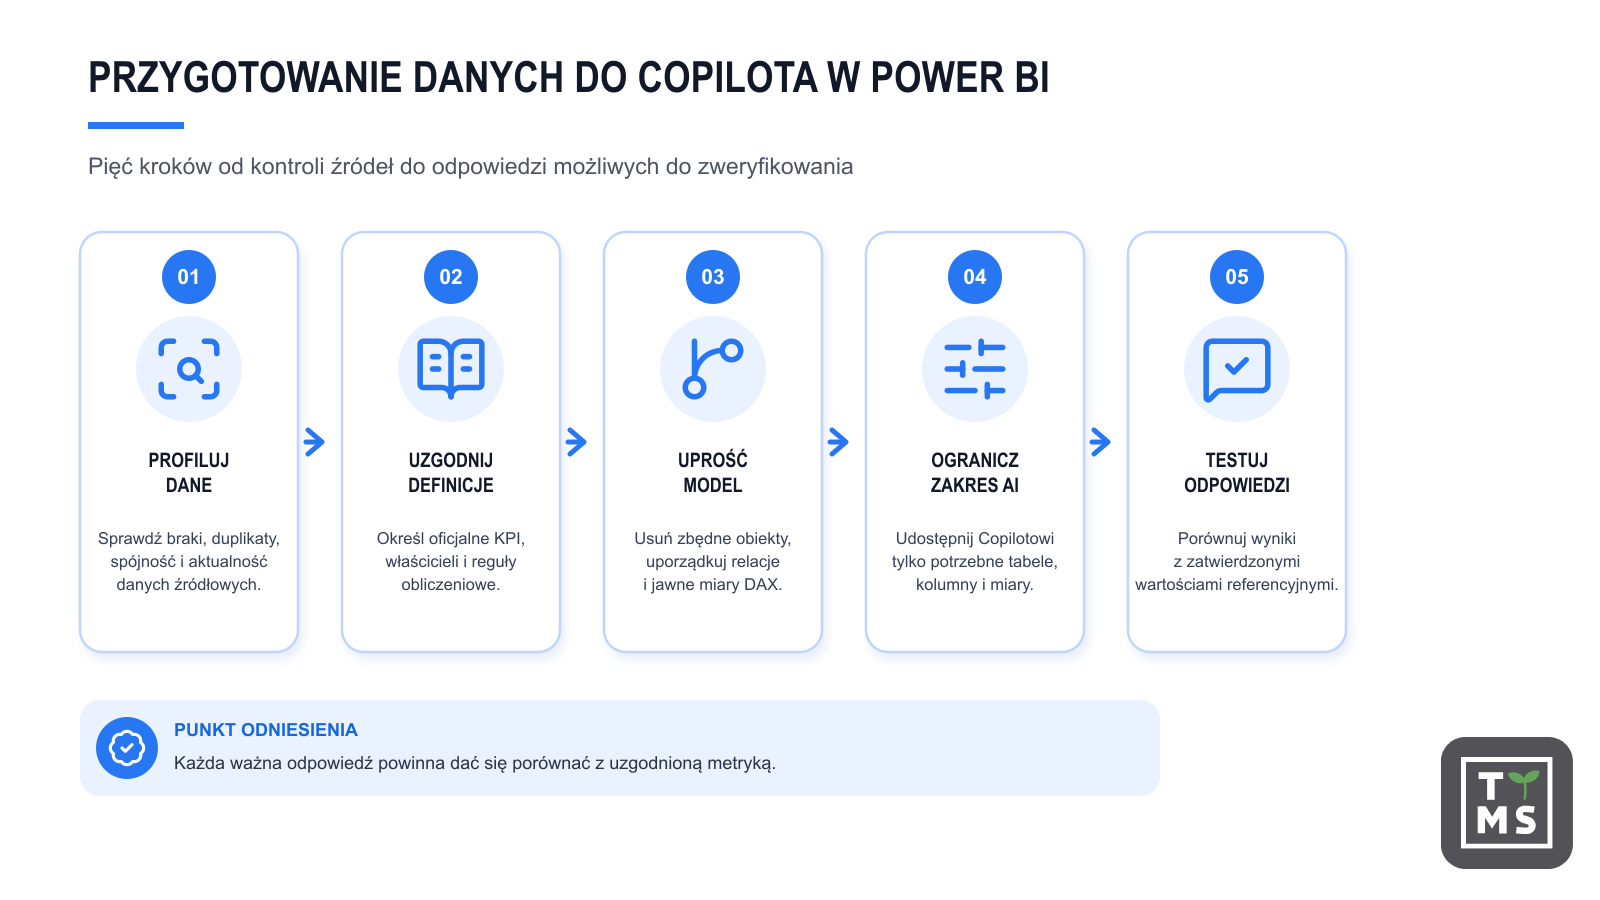
4.1 Jakość danych źródłowych
Pierwszy etap obejmuje profilowanie i kontrolę danych. Należy sprawdzić kompletność, unikalność, spójność, aktualność i zgodność wartości z regułami biznesowymi. Kontrole powinny być powtarzalne, a nie wykonywane wyłącznie przed pierwszą publikacją.
W praktyce oznacza to między innymi:
- identyfikację brakujących kluczy oraz rekordów osieroconych;
- kontrolę duplikatów w tabelach wymiarów;
- uzgodnienie stref czasowych, kalendarzy, walut i jednostek;
- sprawdzenie, czy wartości statusów mają wspólne znaczenie we wszystkich systemach;
- określenie właściciela danych i sposobu obsługi błędów jakościowych;
- monitorowanie świeżości danych oraz nieudanych odświeżeń.
Każda oficjalna metryka powinna mieć określone źródło, właściciela, częstotliwość aktualizacji i regułę obliczeniową. Dzięki temu odpowiedź Copilota można porównać z wartością referencyjną, zamiast oceniać ją wyłącznie na podstawie tego, czy brzmi logicznie.
4.2 Przyjazne nazwy i stabilne definicje
Nazwy techniczne, takie jak „fct_sales_hdr”, „cust_id” czy „rev_net_adj”, zwiększają koszt korzystania z modelu przez człowieka i utrudniają interpretację intencji pytania. W warstwie semantycznej warto stosować nazwy odpowiadające językowi organizacji, na przykład „Sprzedaż”, „Klient”, „Przychód netto” i „Region sprzedaży”.
Sama czytelność nie wystarcza. Nazwa „Marża” nadal jest niejednoznaczna, jeżeli firma używa marży kwotowej, procentowej, planowanej i skorygowanej. Każda z tych miar powinna mieć precyzyjną nazwę i definicję. Jeżeli jedna miara ma status oficjalnej, model powinien to odzwierciedlać przez nazewnictwo, opis, organizację folderów oraz ograniczenie widoczności pól pomocniczych.
4.3 Poprawne typy danych i formaty
Typ danych informuje model, czy wartość jest datą, liczbą, tekstem lub kategorią. Format wskazuje sposób prezentacji, na przykład walutę, procent albo liczbę dziesiętną. Błędny typ może uniemożliwić prawidłowe grupowanie i obliczenia, a niejednoznaczny format może prowadzić do błędnej interpretacji wyniku przez użytkownika.
Warto również wskazać kategorie danych tam, gdzie mają znaczenie, na przykład dla adresów, miast i kodów geograficznych. Model powinien jasno rozróżniać datę zamówienia, wystawienia faktury, wysyłki i płatności. Jedna oznaczona tabela kalendarza oraz jawne miary ograniczają liczbę przypadkowych interpretacji.
5. Model semantyczny zrozumiały dla Copilota
Samouczek Microsoft dotyczący przygotowania modelu semantycznego dla AI zaleca między innymi stosowanie schematu gwiazdy, czytelnych nazw i ograniczanie złożoności. Nie oznacza to, że każdy model musi wyglądać identycznie. Chodzi o to, aby relacje, role tabel i definicje miar były jednoznaczne.
5.1 Schemat gwiazdy
W schemacie gwiazdy tabele faktów przechowują zdarzenia lub wartości liczbowe, a tabele wymiarów opisują kontekst, taki jak klient, produkt, czas i region. Taka struktura ułatwia użytkownikowi oraz mechanizmom AI odróżnienie tego, co jest mierzone, od sposobu podziału wyniku.
Rozbudowany model płatka śniegu, wiele tabel pomocniczych i kilka możliwych ścieżek filtrowania mogą być uzasadnione technicznie, ale zwiększają złożoność interpretacji. Jeżeli nie można uprościć modelu fizycznie, warto ograniczyć zakres udostępniany Copilotowi przez AI data schema.
5.2 Relacje i kierunki filtrowania
Relacje powinny odwzorowywać rzeczywistą logikę danych. Należy zweryfikować ich kardynalność, aktywność i kierunek filtrowania. Relacje dwukierunkowe oraz wiele alternatywnych ścieżek mogą prowadzić do nieoczekiwanych wyników, zwłaszcza gdy pytanie nie określa szczegółowego kontekstu.
Nieaktywne relacje i specjalne reguły stosowane w wybranych miarach należy dokumentować. Jeżeli analiza sprzedaży według daty wysyłki wymaga innej logiki niż analiza według daty zamówienia, użytkownik powinien wiedzieć, jak sformułować pytanie, a model powinien oferować jednoznaczne miary.
5.3 Jawne miary DAX
Jawne miary DAX pozwalają zapisać zatwierdzoną logikę biznesową w jednym miejscu. Są bezpieczniejszą podstawą odpowiedzi niż przypadkowe agregowanie kolumn liczbowych. Miara powinna mieć czytelną nazwę, prawidłowy format, opis i właściciela biznesowego.
Przed udostępnieniem modelu Copilotowi warto sprawdzić:
- czy oficjalne wskaźniki są zdefiniowane jako miary;
- czy nie występują duplikaty o podobnych nazwach;
- czy format wyniku odpowiada znaczeniu biznesowemu;
- czy miary działają prawidłowo dla różnych filtrów i poziomów agregacji;
- czy pola techniczne oraz miary pomocnicze są ukryte przed użytkownikami;
- czy wyniki zostały uzgodnione z raportami referencyjnymi.
6. Funkcja Prep data for AI w Power BI
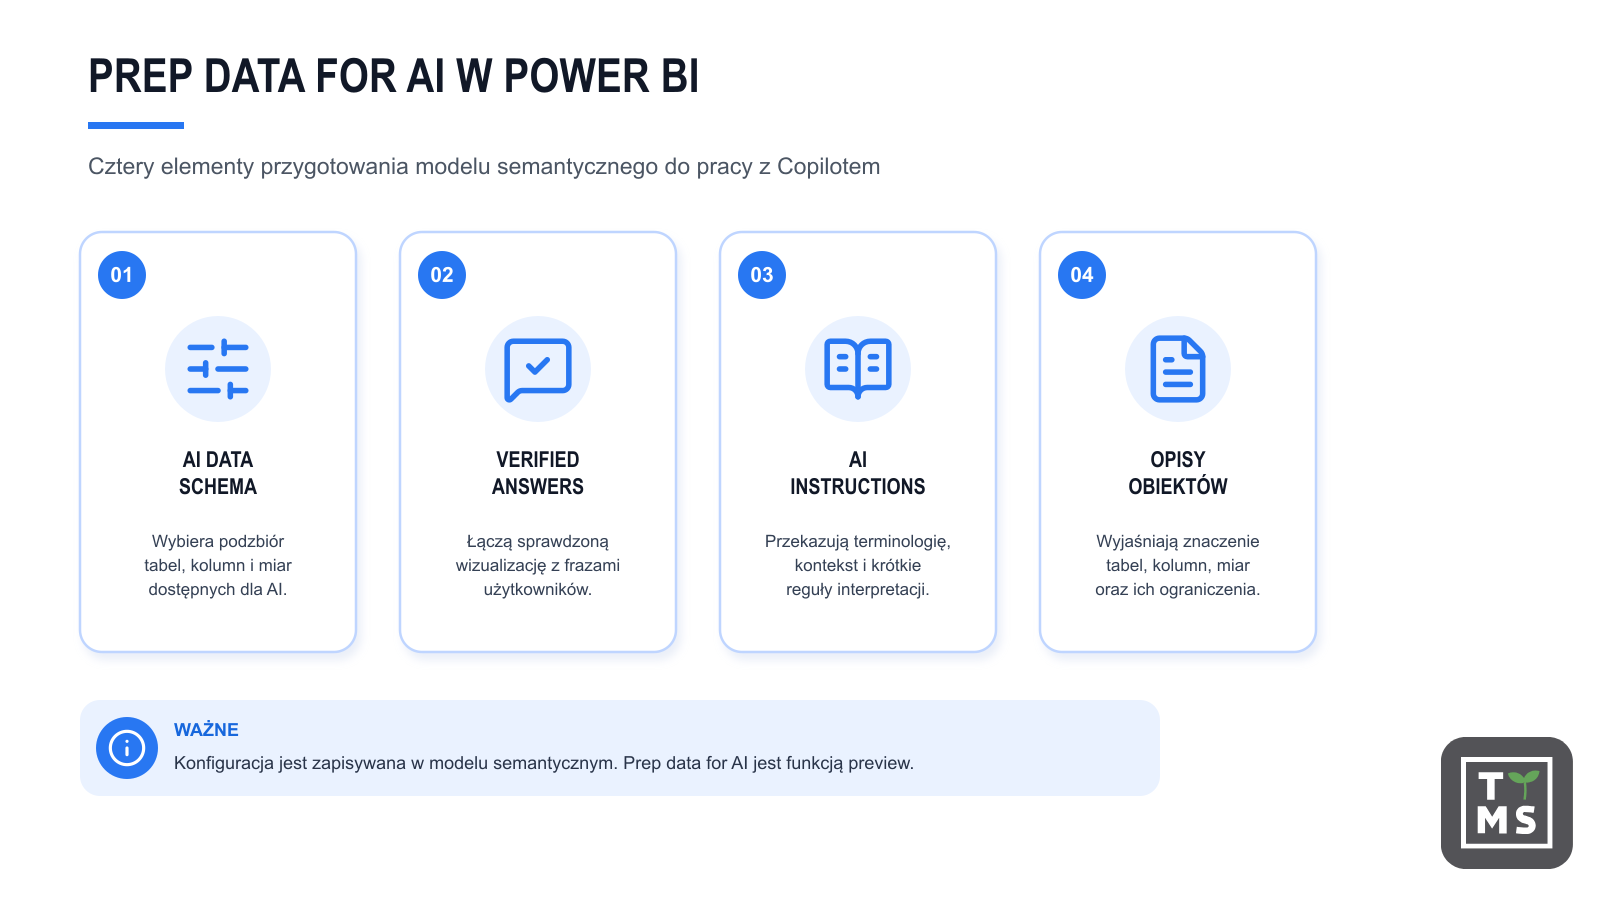
Prep data for AI jest zestawem narzędzi zapisujących konfigurację na poziomie modelu semantycznego, a nie pojedynczego raportu. To istotne, ponieważ jeden model może zasilać wiele raportów. Zmiana schematu AI lub instrukcji może więc wpływać na więcej niż jeden scenariusz użycia.
Microsoft opisuje cztery elementy przygotowania modelu do przetwarzania języka naturalnego: AI data schema (schemat danych AI), verified answers (zweryfikowane odpowiedzi), AI instructions (instrukcje AI) oraz opisy. Poszczególne elementy nie działają jednak identycznie we wszystkich doświadczeniach Copilot. Dlatego konfigurację trzeba testować w tych samych miejscach, w których będą pracowali użytkownicy.
| Mechanizm | Zastosowanie | Kiedy jest szczególnie potrzebny | Czego nie zastępuje |
| AI data schema | Określa podzbiór tabel, kolumn i miar przekazywany Copilotowi | Gdy model jest duży lub zawiera pola techniczne i podobne miary | Porządkowania danych oraz poprawnych relacji |
| Verified answers | Łączy zatwierdzoną wizualizację z frazami uruchamiającymi | Dla częstych lub niejednoznacznych pytań wymagających spójnej interpretacji | Testowania danych źródłowych i kontroli dostępu |
| AI instructions | Przekazuje reguły, definicje i kontekst biznesowy | Gdy organizacja używa pojęć, których znaczenia nie da się wywnioskować z nazw pól | Oficjalnych miar i jednoznacznego modelu |
| Opisy | Dokumentują znaczenie tabel, kolumn i miar | Gdy nazwa obiektu nie wyjaśnia w pełni jego zastosowania | Instrukcji obejmujących reguły całej domeny |
6.1 AI data schema
AI data schema ogranicza część modelu, którą Copilot bierze pod uwagę podczas odpowiadania na pytania o dane. Nie należy automatycznie udostępniać całego schematu. Tabele techniczne, pola kluczy, nieużywane miary i obiekty przeznaczone wyłącznie do obsługi raportu zwiększają liczbę możliwych interpretacji.
Dobrze zaprojektowany schemat AI powinien obejmować oficjalne wymiary, zatwierdzone miary i pola potrzebne do najczęstszych analiz. Zakres należy sprawdzić z właścicielami procesów biznesowych. Zbyt wąski schemat uniemożliwi odpowiedź na uzasadnione pytania, a zbyt szeroki może zwiększyć niejednoznaczność.
6.2 Zweryfikowane odpowiedzi
Verified answers pozwalają powiązać zatwierdzoną wizualizację z określonymi frazami uruchamiającymi. Mechanizm jest przydatny, gdy użytkownicy często pytają o ten sam wskaźnik lub używają kilku określeń o podobnym znaczeniu.
Przykładem może być pytanie o „sprzedaż według obszaru”. Dla jednej organizacji „obszar” oznacza region geograficzny, a dla innej grupę produktową. Zweryfikowana odpowiedź może skierować właściwe sformułowania do wcześniej sprawdzonej wizualizacji. Nie zwalnia to jednak z testowania samej miary, filtrów i uprawnień.
Dla każdej zweryfikowanej odpowiedzi warto zapisać właściciela, obsługiwane pytania, źródło metryki i datę ostatniego przeglądu. Zmiana definicji wskaźnika albo struktury raportu powinna uruchamiać ponowną walidację.
6.3 Instrukcje AI
AI instructions przekazują Copilotowi kontekst, którego nie da się łatwo wyrazić samą strukturą modelu. Mogą wyjaśniać terminologię organizacji, preferowane miary, reguły interpretacji okresów i powiązania pomiędzy pojęciami.
Instrukcja może na przykład wskazywać, że „aktywny klient” oznacza klienta z zakupem w ostatnich 90 dniach, a „sezon wysoki” obejmuje miesiące od czerwca do sierpnia. Powinna używać konkretnych nazw obiektów modelu i krótkich, testowalnych reguł.
Instrukcje nie są mechanizmem bezpieczeństwa i nie gwarantują bezwzględnego przestrzegania każdej reguły. Microsoft zaznacza, że model językowy interpretuje je jako wskazówki. Dlatego ważne definicje finansowe i operacyjne należy nadal implementować w miarach, relacjach i procesach zarządzania danymi.
6.4 Opisy tabel kolumn i miar
Opisy powinny wyjaśniać znaczenie obiektu, sposób jego użycia oraz istotne ograniczenia. Zamiast „wartość sprzedaży” lepiej zapisać, że miara przedstawia przychód netto po rabatach i zwrotach, w walucie raportowej, według daty faktury.
Według aktualnej dokumentacji Microsoftu opisy nie wpływają w jednakowy sposób na wszystkie możliwości Copilota. Są wykorzystywane między innymi w wybranych scenariuszach wyszukiwania i zapytań DAX. Mimo tego warto je uzupełniać, ponieważ poprawiają dokumentację modelu i przygotowują go do dalszego rozwoju funkcji AI.
7. Kontekst biznesowy dla Copilota
Model może być technicznie poprawny, a mimo to nie odpowiadać językowi używanemu przez firmę. Dział sprzedaży może mówić o „kliencie aktywnym”, finanse o „przychodzie rozpoznanym”, a operacje o „zamówieniu zamkniętym”. Każde z tych pojęć wymaga definicji oraz właściciela.
Dobrym punktem wyjścia jest słownik biznesowy obejmujący:
- nazwę pojęcia i jego dopuszczalne synonimy;
- definicję zaakceptowaną przez właściciela biznesowego;
- odpowiadającą tabelę, kolumnę lub miarę w Power BI;
- regułę czasu, waluty, zakresu i agregacji;
- wyjątki oraz przypadki, w których wskaźnika nie należy używać;
- osobę odpowiedzialną za zatwierdzanie zmian.
Słownik nie powinien istnieć wyłącznie poza Power BI. Najważniejsze informacje trzeba przenieść do nazw, opisów, miar, AI instructions i verified answers. W przeciwnym razie użytkownicy i Copilot nadal będą pracowali z niepełnym kontekstem.
8. Bezpieczeństwo i governance danych
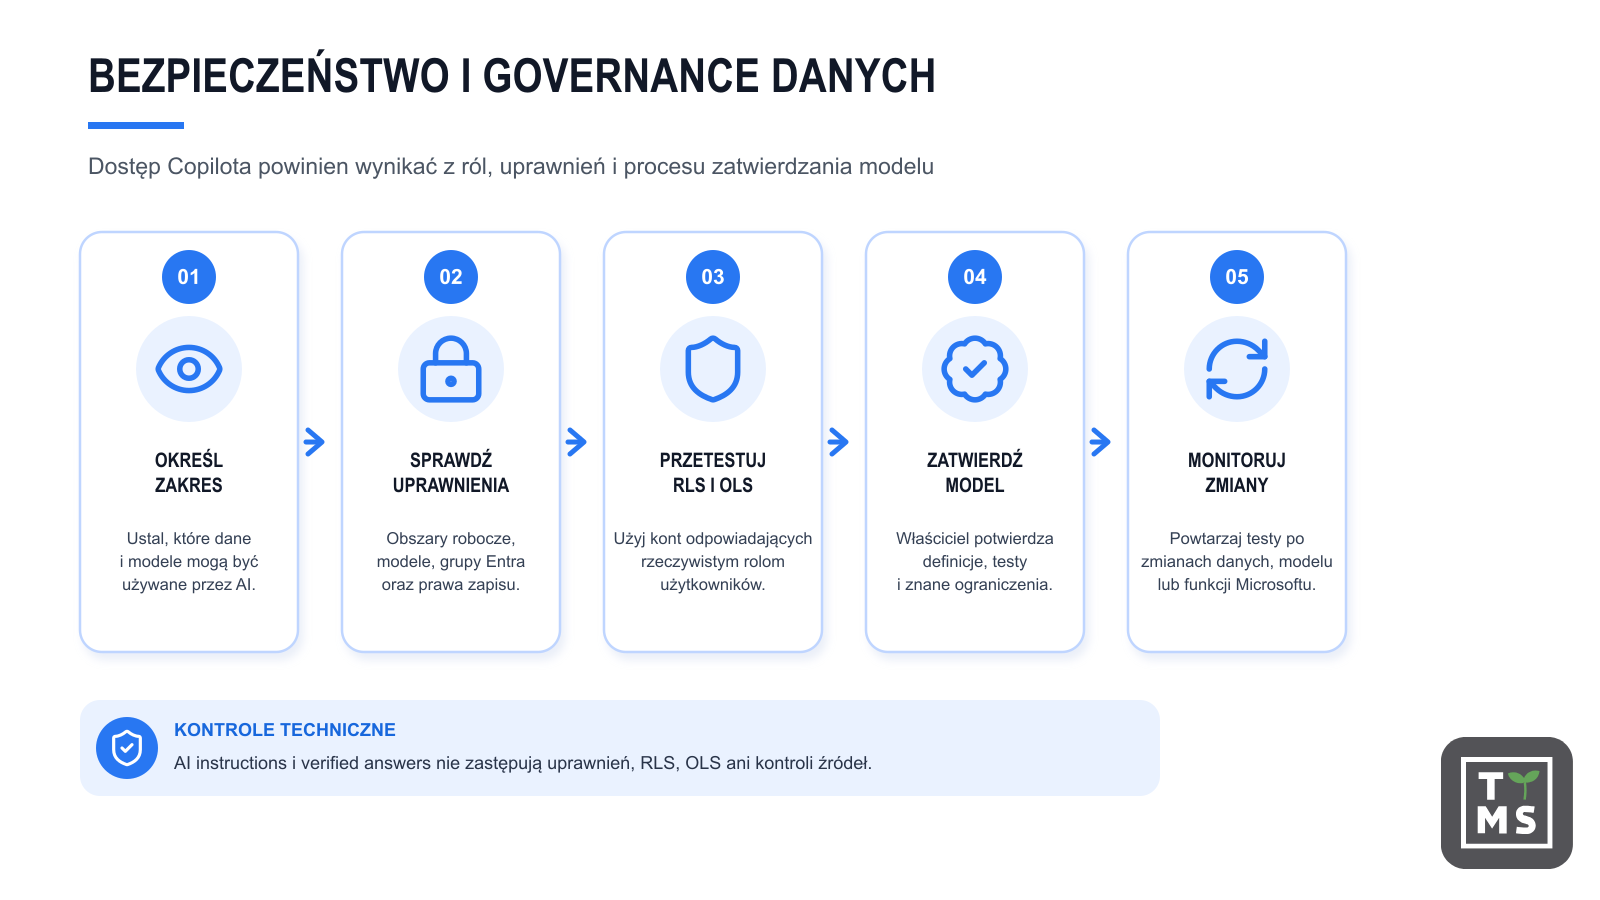
Udostępnienie Copilota zwiększa łatwość zadawania pytań, ale nie zmienia podstawowej zasady: użytkownik powinien mieć dostęp wyłącznie do danych potrzebnych w jego roli. Należy sprawdzić uprawnienia do obszarów roboczych i modeli, role RLS, zabezpieczenia na poziomie obiektów, grupy Microsoft Entra oraz sposób udostępniania raportów i modeli. Przy projektowaniu kontroli warto odnieść się również do zasad prywatności, bezpieczeństwa i odpowiedzialnego korzystania z Copilota w Microsoft Fabric.
Szczególnej uwagi wymagają uprawnienia do zapisu. W Power BI sposób egzekwowania zabezpieczeń na poziomie wiersza zależy między innymi od roli użytkownika i jego uprawnień do modelu. Testy powinny obejmować konta reprezentujące rzeczywiste role, a nie wyłącznie konto autora lub administratora.
Warto również sprawdzić, czy nazwy obiektów, opisy i metadane raportu nie ujawniają informacji, których użytkownik nie powinien poznawać. Dokumentacja Microsoftu dotycząca korzystania z Copilota z modelami semantycznymi wskazuje, że w Power BI Desktop metadane bieżącej strony raportu mogą w określonych sytuacjach służyć jako dane ugruntowujące i zawierać wartości danych. Ocena bezpieczeństwa powinna więc obejmować zarówno rekordy, jak i warstwę opisową modelu.
Governance powinno określać:
- kto może przygotowywać model do użycia przez AI;
- kto zatwierdza definicje i zweryfikowane odpowiedzi;
- które modele mogą zostać oznaczone jako zatwierdzone dla Copilota;
- jak często przeprowadza się testy regresji;
- jak zgłaszane i analizowane są błędne odpowiedzi;
- kiedy zmiana modelu wymaga ponownego zatwierdzenia.
9. Testowanie odpowiedzi Copilota
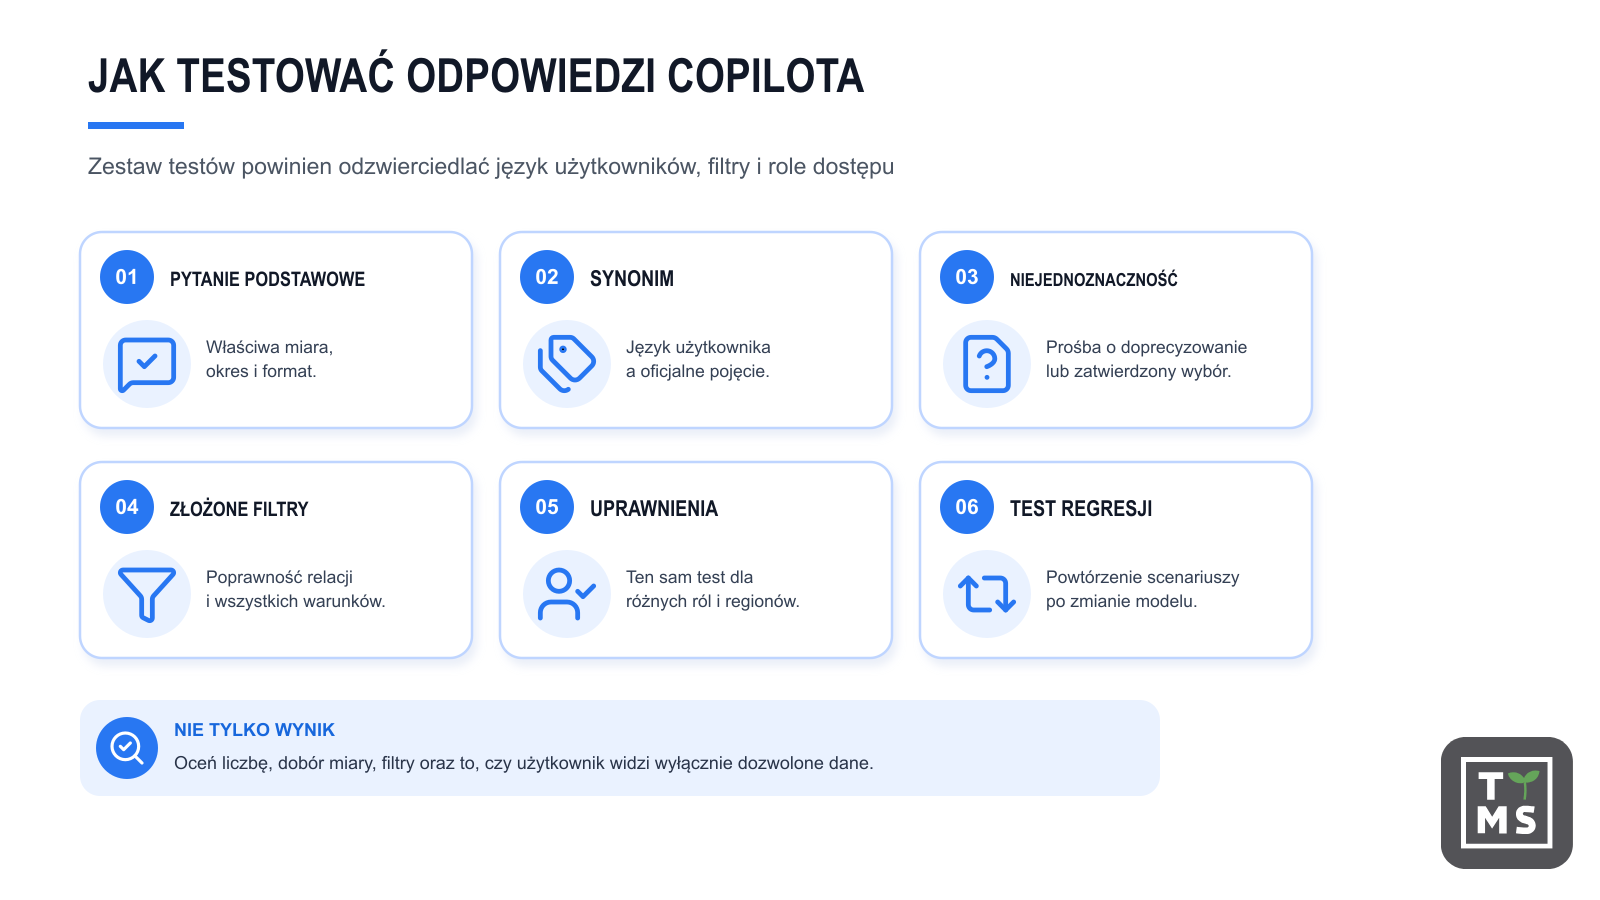
Test nie powinien polegać na zadaniu jednego przykładowego pytania. Potrzebny jest zestaw scenariuszy odzwierciedlających język i potrzeby użytkowników. Dla każdego pytania należy określić oczekiwaną miarę, zakres filtrów, źródło wartości referencyjnej oraz dopuszczalny sposób prezentacji.
| Rodzaj testu | Przykład | Co należy ocenić |
| Pytanie podstawowe | Jaka była sprzedaż netto w poprzednim miesiącu | Dobór miary, okresu i formatu wartości |
| Synonim | Pokaż obrót według regionu | Czy język użytkownika został poprawnie powiązany z oficjalnym pojęciem |
| Pytanie niejednoznaczne | Pokaż wynik dla obszaru | Czy Copilot prosi o doprecyzowanie albo wybiera zatwierdzoną interpretację |
| Filtry złożone | Sprzedaż klientów z sektora produkcyjnego w Polsce w ostatnim kwartale | Poprawność wszystkich filtrów i relacji |
| Uprawnienia | To samo pytanie zadane przez użytkowników z różnych regionów | Czy każdy użytkownik widzi wyłącznie dozwolony zakres danych |
| Odporność na zmianę | Powtórzenie testów po zmianie miary lub relacji | Czy aktualizacja nie pogorszyła wcześniejszych odpowiedzi |
Ocena powinna obejmować zarówno wynik liczbowy, jak i sposób dojścia do odpowiedzi. W dostępnych doświadczeniach warto korzystać z funkcji diagnostycznych, takich jak informacje o tym, jak Copilot utworzył odpowiedź. Nie należy jednak uznawać samego wyjaśnienia mechanizmu za dowód poprawności wyniku. Ostatecznym punktem odniesienia pozostaje zatwierdzona metryka i kontrolowany zestaw danych.
Copilot generuje odpowiedzi niedeterministycznie. To oznacza, że ten sam prompt i te same dane mogą prowadzić do różniących się rezultatów. W niektórych doświadczeniach identyczne pytanie zadane w ciągu 24 godzin przy niezmienionym modelu może jednak zwrócić odpowiedź z pamięci podręcznej. Celem testów nie jest więc udowodnienie, że każda odpowiedź zawsze będzie identyczna. Testy mają wykazać, że model kieruje Copilota do właściwych danych, typowe pytania otrzymują poprawne odpowiedzi, a ryzyka i ograniczenia są znane użytkownikom.
10. Najczęstsze błędy podczas przygotowania Power BI do AI
10.1 Włączenie Copilota przed uporządkowaniem modelu
Zespół koncentruje się na licencji i ustawieniach, ale nie przegląda nazw, relacji i miar. Copilot zostaje udostępniony na modelu, który już wcześniej sprawiał trudności analitykom. Efektem są niejednoznaczne odpowiedzi oraz szybka utrata zaufania użytkowników.
10.2 Udostępnienie całego schematu
Do AI data schema trafiają wszystkie tabele i pola, w tym klucze techniczne, miary pomocnicze oraz obiekty nieużywane. Większa liczba elementów nie oznacza pełniejszego kontekstu. W rozbudowanym modelu może utrudnić wybór właściwego pola.
10.3 Traktowanie instrukcji AI jako zamiennika modelowania
Instrukcje próbują wyjaśnić dziesiątki wyjątków, które powinny zostać zapisane w miarach i regułach modelu. Taki dokument jest trudny do testowania i utrzymania. Im ważniejsza reguła, tym bardziej powinna być egzekwowana przez model lub proces danych, a nie jedynie opisana językiem naturalnym.
10.4 Brak właścicieli metryk
Analitycy przygotowują verified answers bez formalnego potwierdzenia, która definicja wskaźnika jest obowiązująca. W razie rozbieżności nie wiadomo, kto może zaakceptować zmianę ani jaka wartość stanowi punkt odniesienia.
10.5 Testowanie wyłącznie przez autorów
Autor modelu zna nazwy i strukturę danych, dlatego formułuje pytania w sposób zgodny z projektem. Użytkownicy biznesowi używają skrótów, synonimów i niepełnych określeń. Testy powinny obejmować rzeczywiste pytania zebrane od przyszłych użytkowników.
10.6 Brak testów po zmianach
Zmiana definicji miary, relacji, nazwy pola lub raportu może wpłynąć na wcześniejsze scenariusze. Bez testów regresji organizacja nie wie, czy model nadal jest gotowy do użycia przez Copilota.
11. Checklista gotowości modelu Power BI do Copilota
[ ] Zidentyfikowaliśmy właścicieli danych, modeli i kluczowych metryk.
[ ] Dane źródłowe przechodzą powtarzalne kontrole jakości i świeżości.
[ ] Oficjalne wskaźniki mają jednoznaczne definicje oraz jawne miary DAX.
[ ] Nazwy tabel, kolumn i miar odpowiadają językowi biznesowemu.
[ ] Pola techniczne, nieużywane i pomocnicze są ukryte lub usunięte z zakresu AI.
[ ] Typy danych, formaty, kategorie oraz tabela kalendarza są poprawnie skonfigurowane.
[ ] Relacje mają właściwą kardynalność i nie tworzą niejednoznacznych ścieżek filtrowania.
[ ] Zdefiniowaliśmy AI data schema obejmujący wyłącznie potrzebne obiekty.
[ ] Najczęstsze i najbardziej niejednoznaczne pytania mają zweryfikowane odpowiedzi.
[ ] AI instructions opisują terminologię i reguły, których nie da się odczytać ze struktury modelu.
[ ] Tabele, kolumny i miary posiadają przydatne opisy.
[ ] Zweryfikowaliśmy ustawienia dzierżawy, pojemność, licencje i aktualne ograniczenia funkcji.
[ ] Przetestowaliśmy role RLS, uprawnienia i dostęp do modeli na kontach użytkowników testowych.
[ ] Zestaw testów obejmuje pytania podstawowe, synonimy, niejednoznaczności i złożone filtry.
[ ] Wyniki Copilota są porównywane z zatwierdzonymi raportami lub wartościami referencyjnymi.
[ ] Określiliśmy proces zgłaszania błędnych odpowiedzi i ponownej walidacji modelu.
[ ] Jeśli organizacja korzysta z dostępnego obecnie w wersji zapoznawczej ustawienia Approved for Copilot, model jest oznaczany dopiero po zakończeniu testów.
12. Jak przygotować organizację do korzystania z Copilota
Gotowy model nie wystarczy, jeżeli użytkownicy nie wiedzą, jak interpretować odpowiedzi. Wdrożenie powinno obejmować krótkie szkolenie, przykładowe pytania, wyjaśnienie zakresu danych i zasady weryfikacji wyników. Należy jasno wskazać, które scenariusze mają charakter wspierający, a które wymagają kontroli analityka lub właściciela procesu.
Dobrym rozwiązaniem jest pilotaż na jednym modelu o dobrze zdefiniowanym zakresie. Pozwala zebrać pytania użytkowników, ocenić niejednoznaczności i zbudować zestaw testów przed rozszerzeniem funkcji na kolejne obszary. Pilotaż powinien mieć kryteria zakończenia, na przykład poprawność najważniejszych scenariuszy, akceptację właścicieli metryk i brak krytycznych problemów z uprawnieniami.
Po uruchomieniu warto monitorować wykorzystanie, koszt pojemności, zgłoszenia użytkowników oraz zmiany w dokumentacji Microsoftu. Gotowość modelu do pracy z AI wymaga stałego monitorowania i ponownych testów po istotnych zmianach.
13. Dlaczego TTMS
Przygotowanie Power BI do pracy z Copilotem wymaga połączenia kompetencji z zakresu integracji danych, modelowania semantycznego, Power BI, Microsoft Fabric, bezpieczeństwa i adopcji użytkowników. Skupienie się wyłącznie na interfejsie Copilota nie rozwiązuje problemów znajdujących się w źródłach, transformacjach i definicjach biznesowych.
Zakres współpracy z TTMS może obejmować ocenę gotowości istniejących modeli, uporządkowanie warstwy danych, przebudowę relacji i miar oraz przygotowanie testów. Konfigurację Prep data for AI warto poprzedzić potwierdzeniem wymagań środowiska i uzgodnieniem zakresu prac. Współpraca może dotyczyć pojedynczego modelu pilotażowego albo programu obejmującego wiele domen i zespołów.
Praktyczny model współpracy może obejmować:
- Inwentaryzację źródeł, modeli, raportów i grup użytkowników.
- Ocenę jakości danych, architektury modelu oraz ryzyka niejednoznacznych odpowiedzi.
- Uzgodnienie oficjalnych wskaźników i słownika pojęć biznesowych.
- Optymalizację modelu semantycznego oraz konfigurację AI data schema, verified answers i AI instructions.
- Testy funkcjonalne, regresyjne, bezpieczeństwa i wydajności.
- Przygotowanie zasad governance, dokumentacji oraz materiałów dla użytkowników.
- Utrzymanie modeli i ponowną walidację po zmianach danych lub funkcji Microsoftu.
Rezultatem powinien być model, którego struktura jest czytelna dla analityków i użytkowników biznesowych, a odpowiedzi Copilota można oceniać względem zatwierdzonych definicji. Celem jest ograniczenie niejednoznaczności i wprowadzenie procesu kontroli jakości. Nawet dobrze przygotowany model nie gwarantuje bezbłędnych odpowiedzi generatywnej AI.
14. Rozmowa o gotowości Power BI do AI
Jeżeli Twoja organizacja korzysta z Power BI i planuje udostępnić Copilota, warto rozpocząć od przeglądu danych oraz modeli semantycznych. TTMS może pomóc określić zakres pilotażu, wskazać luki i przygotować roadmapę prac od źródeł danych do testów użytkowników.
Skontaktuj się z TTMS, aby omówić przygotowanie środowiska Power BI i Microsoft Fabric do bezpiecznego wykorzystania funkcji AI.
15. FAQ
Kto powinien być właścicielem modelu semantycznego przygotowanego dla Copilota?
Model semantyczny powinien mieć jasno określonych właścicieli odpowiedzialnych za jakość danych, definicje wskaźników biznesowych oraz utrzymanie modelu. Dzięki temu zmiany w danych, procesach i raportowaniu mogą być kontrolowane, a odpowiedzi Copilota pozostają zgodne z aktualnymi definicjami biznesowymi.
Jak duży powinien być AI data schema w Power BI?
AI data schema powinien obejmować wyłącznie te tabele, kolumny i miary, które są potrzebne do realizacji najczęściej zadawanych pytań biznesowych. Zbyt szeroki zakres zwiększa ryzyko niejednoznacznych odpowiedzi, natomiast zbyt wąski może ograniczyć możliwości Copilota i uniemożliwić analizę części danych.
Czy Copilot może rozumieć pojęcia biznesowe, których nie ma bezpośrednio w modelu danych?
Tak, częściowo. Kontekst można przekazywać za pomocą opisów, AI instructions, verified answers i odpowiednio nazwanych miar. Najważniejsze pojęcia biznesowe powinny jednak być odwzorowane bezpośrednio w modelu semantycznym, ponieważ zwiększa to dokładność interpretacji i zmniejsza ryzyko błędnych odpowiedzi.
Kiedy należy ponownie zweryfikować model Power BI pod kątem Copilota?
Model warto ponownie zweryfikować po każdej istotnej zmianie dotyczącej źródeł danych, definicji KPI, relacji, uprawnień, konfiguracji AI lub funkcji Microsoft Copilot. Regularne testy regresji pomagają potwierdzić, że wcześniej poprawne scenariusze nadal działają zgodnie z oczekiwaniami.
Czy użytkownicy powinni bezwarunkowo ufać odpowiedziom Copilota?
Nie. Odpowiedzi Copilota należy traktować jako wsparcie procesu podejmowania decyzji, a nie jako jedyne źródło prawdy. Kluczowe decyzje biznesowe powinny być weryfikowane w oparciu o zatwierdzone miary, raporty referencyjne oraz procedury governance obowiązujące w organizacji.