Cykl życia oprogramowania stale przyspiesza. Zespoły deweloperskie wdrażają zmiany coraz częściej, a od QA oczekuje się szybkiego dostarczania informacji zwrotnej bez kompromisów w obszarze jakości. W takich realiach automatyzacja testów nie jest już przewagą konkurencyjną, lecz standardowym elementem procesu wytwarzania oprogramowania.
Sama liczba testów automatycznych nie gwarantuje jednak lepszego pokrycia, szybszych wdrożeń ani większej stabilności produktu. Wiele organizacji przekonuje się, że rozbudowywanie zestawów testowych bez odpowiedniej strategii prowadzi do rosnących kosztów utrzymania, problemów z niezawodnością oraz coraz wolniejszego procesu dostarczania zmian.
Najbardziej efektywne zespoły traktują automatyzację jako integralną część procesu QA i software delivery. Obejmuje to nie tylko tworzenie testów, ale również ich odpowiednią selekcję, wybór narzędzi i frameworków, integrację z CI/CD, regularne utrzymanie oraz świadome zarządzanie kodem automatyzacji.
W tym artykule przedstawiamy najważniejsze praktyki, które pomagają budować skalowalną i łatwą w utrzymaniu automatyzację testów w 2026 roku.
1. Dlaczego najlepsze praktyki automatyzacji testów mają kluczowe znaczenie w 2026 roku?
Współczesne aplikacje coraz częściej opierają się na zintegrowanych usługach, dynamicznie zmieniających się interfejsach oraz coraz krótszych cyklach delivery. Testy automatyczne obejmują dziś nie tylko aplikacje webowe, ale również aplikacje mobilne, API, integracje oraz krytyczne ścieżki użytkownika. W efekcie równie ważne jak liczba testów w suite staje się sposób planowania, budowania i utrzymywania automatyzacji.
Bez jasno określonych standardów automatyzacja bardzo szybko może stać się dodatkowym źródłem problemów zamiast wsparciem dla procesu delivery. Niestabilne testy spowalniają pipeline’y CI/CD, nieaktualne skrypty przestają odzwierciedlać bieżące wymagania biznesowe, a duplikowanie pokrycia testowego zwiększa czas wykonywania testów i koszty utrzymania bez realnej poprawy jakości.
Jak opisaliśmy w naszym artykule o AI end-to-end testing, skuteczna i skalowalna automatyzacja wymaga jasno określonej odpowiedzialności za testy, pełnej traceability, regularnego utrzymania oraz świadomego powiązania wymagań biznesowych z celami testów, ich wykonaniem i uzyskiwanymi wynikami. To właśnie te elementy pozwalają budować automatyzację, która wspiera rozwój produktu zamiast generować dodatkowy dług technologiczny.
2. Jak decydować, które testy warto automatyzować?
Nie każdy test powinien trafić do zestawu testów automatycznych. Skuteczna automatyzacja wymaga uporządkowanego podejścia, które pozwala identyfikować scenariusze przynoszące realną wartość biznesową, zamiast generować dodatkowe koszty utrzymania.
2.1 Oceniaj testy pod kątem częstotliwości, stabilności i kosztów
Praktycznym sposobem wyboru testów do automatyzacji jest ocena każdego scenariusza pod kątem kilku kluczowych kryteriów: częstotliwości wykonywania, stabilności testowanej funkcjonalności, znaczenia biznesowego oraz nakładu pracy potrzebnego do wdrożenia i utrzymania automatyzacji.
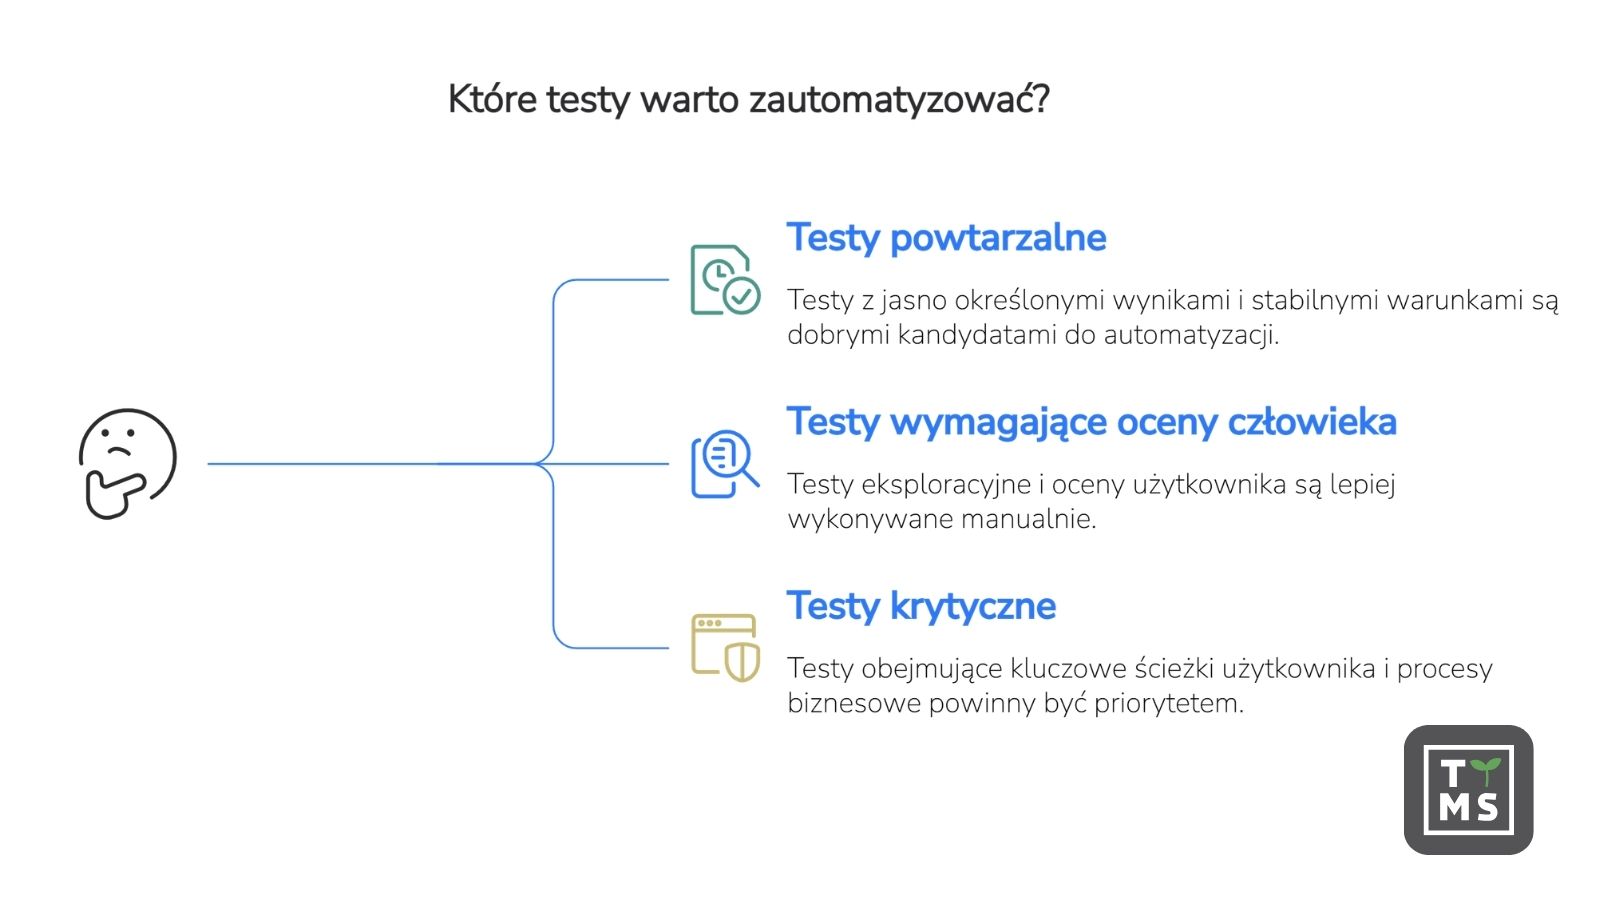
Najlepszymi kandydatami są zwykle powtarzalne scenariusze z jasno określonym oczekiwanym wynikiem, stabilnymi warunkami początkowymi, wiarygodnymi danymi testowymi oraz istotnym wpływem na jakość wydań. Sam fakt częstego wykonywania testu nie jest jednak wystarczającym argumentem. Warto również ocenić, czy scenariusz można wykonywać w sposób powtarzalny oraz czy jego rezultat można zweryfikować bez subiektywnej oceny.
2.2 Testy wymagające oceny człowieka pozostaw manualne
Exploratory testing, ocena pierwszych doświadczeń użytkownika, analiza aspektów wizualnych czy scenariusze wymagające interpretacji ze strony testera zwykle lepiej sprawdzają się jako testy manualne. Próba ich automatyzacji często eliminuje elastyczność i obserwacje, które stanowią ich największą wartość.
Jednocześnie rzadkie występowanie danego scenariusza nie oznacza automatycznie, że nie warto go automatyzować. Jeśli ewentualna awaria mogłaby zakłócić krytyczny proces biznesowy, zagrozić integralności danych lub generować wysokie ryzyko operacyjne, automatyzacja może być w pełni uzasadniona. Ostateczna decyzja powinna uwzględniać zarówno częstotliwość wykonywania testu, jak i jego wpływ na biznes.
2.3 Priorytetowo traktuj krytyczne ścieżki użytkownika
Po odrzuceniu scenariuszy, które nie nadają się do automatyzacji, warto uszeregować pozostałe testy według ich znaczenia biznesowego oraz ryzyka regresji.
Najczęściej priorytet otrzymują procesy związane z logowaniem, realizacją zakupów, dostępem do kont użytkowników, akceptacjami oraz kluczowymi procesami transakcyjnymi. Problemy w tych obszarach mogą bezpośrednio uniemożliwić użytkownikom korzystanie z najważniejszych funkcji systemu.
Rozpoczęcie automatyzacji od takich scenariuszy pozwala zabezpieczyć najbardziej krytyczne elementy aplikacji już na wczesnym etapie. Testy dotyczące mniej istotnych funkcjonalności można dodawać stopniowo, gdy korzyści wynikające z automatyzacji uzasadniają koszty ich wdrożenia i późniejszego utrzymania.
3. Dopasuj strategię automatyzacji do aplikacji i kompetencji zespołu
Po wytypowaniu testów, które warto zautomatyzować, kolejnym krokiem jest wybór podejścia najlepiej dopasowanego do aplikacji, sposobu dostarczania oprogramowania oraz kompetencji zespołu. Decyzja powinna uwzględniać nie tylko szybkość wykonywania testów, ale również łatwość utrzymania, poziom kontroli technicznej, dostępność rozwiązania dla zespołu QA oraz sposób integracji automatyzacji z istniejącym procesem developmentu.
3.1 Korzystaj z Test Pyramid, aby zachować równowagę między szybkością i pokryciem testowym
Test Pyramid nadal pozostaje jednym z najskuteczniejszych modeli projektowania automatyzacji. Jej podstawę stanowią szybkie unit tests, wyższy poziom zajmują integration tests oraz service-level tests, a na szczycie znajduje się mniejsza liczba end-to-end tests weryfikujących kompletne ścieżki użytkownika.
Dokładne proporcje pomiędzy poszczególnymi warstwami powinny wynikać z architektury aplikacji oraz obszarów największego ryzyka. System oparty na wielu usługach może wymagać większego nacisku na testy integracyjne, podczas gdy aplikacja biznesowa często potrzebuje szerszego pokrycia kluczowych procesów za pomocą testów end-to-end.
Celem jest wykrywanie problemów na możliwie najniższym poziomie przy jednoczesnym zachowaniu wystarczającej liczby testów end-to-end, które potwierdzają poprawne działanie najważniejszych ścieżek użytkownika.
3.2 Wybierz między code-based, codeless i podejściem hybrydowym
Code-based automation zapewnia pełną kontrolę nad architekturą testów, integracjami, reużywalnymi komponentami oraz standardami obowiązującymi w repozytorium. Takie podejście najlepiej sprawdza się w zespołach posiadających silne kompetencje techniczne, bardziej złożone wymagania testowe lub rozwinięte frameworki automatyzacji.
Codeless oraz low-code automation ograniczają ilość kodu potrzebnego do definiowania typowych scenariuszy testowych. Dzięki temu automatyzacja staje się bardziej dostępna dla testerów manualnych i ekspertów biznesowych. Warto jednak zwrócić uwagę na to, jak dana platforma radzi sobie z bardziej złożoną logiką, utrzymaniem testów, version control oraz ownership automatyzacji.
Coraz więcej organizacji wybiera model hybrydowy, który łączy prostotę definiowania testów z elastycznością klasycznej automatyzacji. Testerzy QA mogą definiować i weryfikować założenia testów, podczas gdy Automation Engineerowie odpowiadają za standardy techniczne oraz utrzymanie generowanego kodu. Takie podejście ogranicza liczbę przekazań pomiędzy zespołami bez zamykania się na jedno, proprietarne rozwiązanie.
3.3 Oceń dopasowanie technologiczne i długoterminowe utrzymanie
Wybór odpowiedniej metodologii powinien wynikać z charakteru testowanego systemu oraz tego, kto będzie odpowiadał za utrzymanie automatyzacji w dłuższej perspektywie.
Złożone procesy backendowe i integracje usług często wymagają pełnej kontroli technicznej, podczas gdy powtarzalne ścieżki użytkownika w aplikacjach webowych mogą być dobrym kandydatem do wykorzystania codeless automation.
Warto również odpowiedzieć sobie na kilka praktycznych pytań:
Gdzie będą uruchamiane wygenerowane testy?
Czy ich kod będzie dostępny w istniejącym repozytorium?
W jaki sposób wyniki testów wrócą do procesu QA?
Czy wybrane rozwiązanie spełnia wymagania organizacji dotyczące bezpieczeństwa i deploymentu?
Popularność narzędzia ma znacznie mniejsze znaczenie niż jego dopasowanie do architektury aplikacji, kompetencji zespołu, modelu governance oraz kosztów długoterminowego utrzymania automatyzacji.
4. Projektuj automatyzację z myślą o łatwym utrzymaniu
Sposób projektowania testów i frameworków ma ogromny wpływ na długoterminową stabilność automatyzacji, niezależnie od wykorzystywanych narzędzi. Dobrze zaprojektowana automatyzacja oddziela warstwę techniczną od logiki biznesowej testu, wykorzystuje spójne standardy pracy z repozytorium i ułatwia analizę oraz naprawę błędów.
4.1 Korzystaj ze stabilnych locatorów
Locatory bazujące na pozycji elementu na stronie, dynamicznie generowanych identyfikatorach lub rozbudowanych ścieżkach DOM często prowadzą do niestabilnych testów po zmianach w interfejsie.
Tam, gdzie to możliwe, warto wykorzystywać selektory oparte na stabilnych atrybutach, takich jak dedykowane identyfikatory testowe, role dostępności (accessibility roles), etykiety lub inne elementy odpowiadające rzeczywistym interakcjom użytkowników z aplikacją.
Dobry locator powinien być zarówno stabilny, jak i wystarczająco precyzyjny, aby jednoznacznie wskazywać właściwy element. Celem nie jest całkowite wyeliminowanie maintenance, ale ograniczenie błędów wynikających ze zmian technicznych niezwiązanych z faktycznie testowaną funkcjonalnością.
4.2 Wykorzystuj reużywalne wzorce projektowe
Wzorce takie jak Page Object Model (POM) pozwalają oddzielić interakcje z aplikacją od logiki biznesowej weryfikowanej przez testy. Dzięki temu zmiana elementu interfejsu wymaga aktualizacji jednego komponentu zamiast modyfikacji dziesiątek testów.
W zależności od projektu warto również korzystać z takich elementów jak component objects, współdzielone fixtures, funkcje pomocnicze, reużywalne akcje czy własne warstwy abstrakcji. Kluczowe znaczenie ma konsekwentne stosowanie wybranych wzorców w całym repozytorium.
4.3 Twórz jednoznaczne asercje
Każdy test automatyczny powinien zawierać jasno określony i możliwy do zweryfikowania oczekiwany rezultat. Scenariusz, który wykonuje serię kroków bez sprawdzenia efektu końcowego, może zakończyć się statusem „passed”, mimo że testowany proces biznesowy nie działa poprawnie.
Asercje powinny potwierdzać oczekiwane zachowanie aplikacji, a nie przypadkowe szczegóły implementacji. Jasno zdefiniowane oczekiwane rezultaty ułatwiają również review testów, diagnostykę błędów oraz traceability względem wymagań biznesowych.
4.4 Traktuj test data management jako osobny obszar
Dane testowe powinny mieć jasno określonego właściciela oraz powtarzalny proces przygotowania. Tworzenie, inicjalizacja, współdzielenie, zabezpieczanie i czyszczenie danych testowych warto zaplanować już podczas projektowania testów, a nie dopiero po stworzeniu skryptów.
Zespoły powinny również unikać ukrytych zależności od danych pozostawionych przez wcześniejsze wykonania testów. Przewidywalne dane testowe ułatwiają odtwarzanie błędów oraz ograniczają liczbę fałszywych wyników wynikających z nieaktualnych, niekompletnych lub niespójnych rekordów.
4.5 Dbaj o niezależność testów
Testy automatyczne nie powinny zależeć od kolejności wykonywania innych testów. Każdy scenariusz powinien rozpoczynać się od znanego stanu systemu i samodzielnie przygotowywać warunki niezbędne do wykonania testu.
Izolację można osiągnąć między innymi poprzez użycie fixtures, kontrolowane przygotowanie danych testowych, oddzielne konteksty przeglądarki, przygotowanie danych przez API, reset środowiska lub procedury cleanup. Awaria pojedynczego testu nie powinna powodować błędnych wyników w innych częściach test suite.
4.6 Stosuj spójne standardy repozytorium
Kod automatyzacji powinien podlegać tym samym standardom jakościowym co pozostała część projektu. Spójne nazewnictwo, struktura katalogów, sposób wykorzystania fixtures, helperów, hooków, obsługa błędów, formatowanie kodu oraz zasady code review sprawiają, że zarówno ręcznie tworzone, jak i generowane testy są łatwiejsze do zrozumienia i utrzymania.
Ma to szczególne znaczenie w projektach, w których część kodu automatyzacji jest generowana automatycznie. Wygenerowany kod powinien wpisywać się w istniejący framework i standardy repozytorium, zamiast tworzyć równoległą strukturę, którą zespół będzie musiał utrzymywać oddzielnie.
5. Integruj odpowiednie testy na właściwym etapie CI/CD
Testy automatyczne przynoszą największą wartość wtedy, gdy są częścią pipeline’u CI/CD i dostarczają szybką oraz użyteczną informację zwrotną osobom odpowiedzialnym za wdrażane zmiany. Celem nie jest uruchamianie wszystkich testów po każdej modyfikacji kodu, lecz dopasowanie zakresu testowania do konkretnego etapu procesu delivery.
5.1 Dopasuj zakres testów do etapu pipeline’u
Dobrze zaprojektowany pipeline pozwala zachować równowagę pomiędzy szybkością feedbacku a głębokością walidacji. Na wczesnych etapach zmianę mogą weryfikować szybkie unit tests oraz statyczna analiza kodu. Na etapie pull requestów lub merge requestów warto uruchamiać integration tests oraz odpowiednio dobrany fragment regression suite, który pozwala ocenić wpływ zmiany na szerszy obszar aplikacji.
Bardziej rozbudowane testy regresyjne mogą być wykonywane po połączeniu zmian z główną gałęzią, przed wdrożeniem, według harmonogramu lub w sytuacjach, gdy poziom ryzyka uzasadnia szerszą walidację.
Smoke tests pełnią inną funkcję. Ich zadaniem jest szybkie potwierdzenie, że wdrożona aplikacja działa, jest dostępna dla użytkowników i obsługuje najbardziej krytyczne ścieżki biznesowe. Powinny one uzupełniać testy regresyjne, a nie je zastępować.
Struktura pipeline’u i oczekiwany czas wykonywania testów powinny być dostosowane do architektury aplikacji, infrastruktury, częstotliwości wydań oraz poziomu ryzyka biznesowego. Każdy zespół powinien zdefiniować własne quality gates, określające, jakie dowody jakości są wymagane przed przejściem do kolejnego etapu procesu.
5.2 Dobieraj testy na podstawie zmian i poziomu ryzyka
Uruchamianie pełnego test suite po każdej zmianie w kodzie z czasem zaczyna wydłużać proces delivery. Bardziej efektywne podejście polega na wybieraniu testów na podstawie komponentów objętych zmianą, powiązanych wymagań biznesowych, krytycznych procesów, historii wcześniejszych uruchomień oraz znanych obszarów ryzyka.
Proces selekcji testów powinien być transparentny. Zespół powinien rozumieć, dlaczego dany test został uwzględniony lub pominięty, a także mieć możliwość rozszerzenia zakresu walidacji, jeżeli analiza wpływu zmiany okaże się niepełna lub pojawią się nowe ryzyka.
Ta warstwowa, oparta na ryzyku struktura jest też fundamentem, na którym opiera się selekcja i priorytetyzacja testów wspierana przez AI. Jeśli interesuje Cię, jak AI wpisuje się właśnie w ten etap pipeline’u, sprawdź nasz przewodnik AI w automatyzacji testów oprogramowania: przewodnik 2026.
5.3 Dostarczaj wyniki, które pomagają podejmować decyzje
Wyniki testów powinny dostarczać znacznie więcej informacji niż jedynie status „passed” lub „failed”. Raport powinien wskazywać, który scenariusz zakończył się błędem, zawierać dane pozwalające przeprowadzić analizę problemu oraz zachowywać powiązanie z wymaganiem biznesowym, przypadkiem testowym, zmianą w kodzie i historią wykonania testu.
Prezentowanie wyników bezpośrednio w pull requestach lub merge requestach pozwala zespołom developerskim analizować rezultaty automatyzacji równocześnie ze zmianami w kodzie. Z kolei przekazywanie wyników do narzędzi QA i systemów zarządzania wymaganiami zapewnia pełną traceability od wymagania biznesowego, przez implementację testu, aż po jego wykonanie. Takie podejście zamyka pętlę feedbacku i pozwala podejmować decyzje release’owe w oparciu o rzetelne dane, a nie domysły.
6. Traktuj utrzymanie testów jako ciągły proces
Flaky tests mogą bardzo szybko podważyć zaufanie do automatyzacji. Gdy ten sam test raz przechodzi, a raz kończy się niepowodzeniem bez żadnej istotnej zmiany w aplikacji, zespoły zaczynają traktować wyniki jako szum informacyjny. Ponowne uruchomienie testu może tymczasowo odblokować pipeline, ale nie rozwiązuje rzeczywistego problemu.
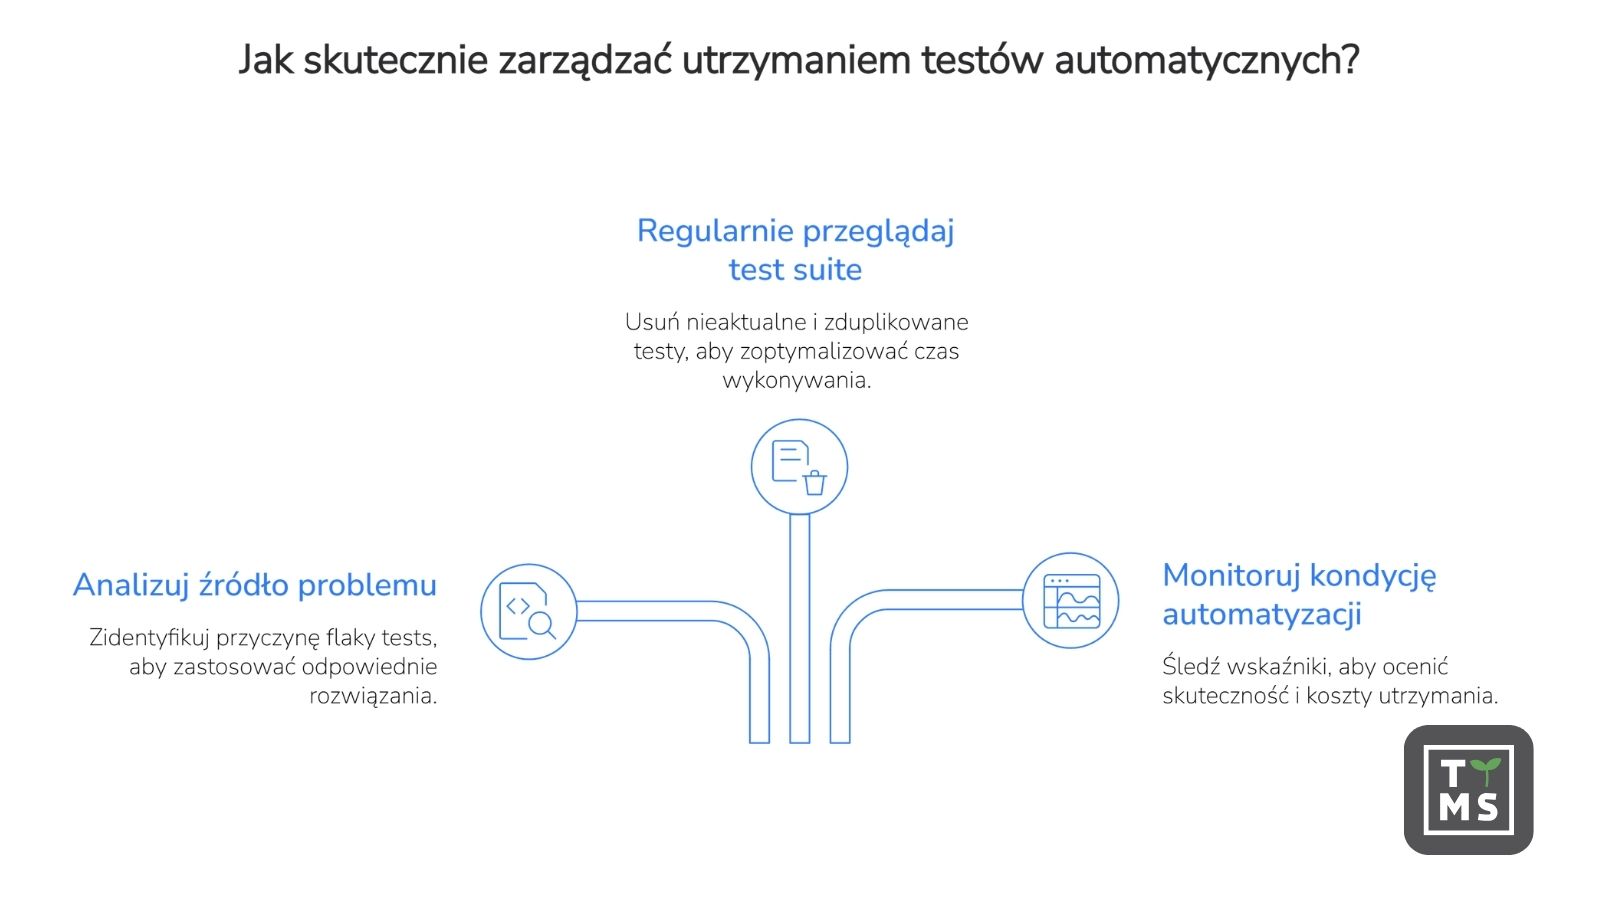
6.1 Analizuj źródło problemu, a nie objawy
Przyczyna występowania flaky tests może leżeć w kodzie testów, samej aplikacji, danych testowych, środowisku wykonawczym lub zewnętrznych zależnościach. Do najczęstszych powodów należą sztywne opóźnienia (fixed delays), brak odpowiedniej synchronizacji, niestabilne locatory, współdzielony stan pomiędzy testami, konfliktujące dane testowe, asynchroniczne działanie aplikacji, zmienność połączeń sieciowych oraz ograniczenia zasobów środowiska wykonawczego.
Sposób rozwiązania problemu powinien odpowiadać jego źródłu. Problemy związane z timingiem często wymagają zastosowania warunkowych mechanizmów oczekiwania zamiast wydłużania opóźnień. Błędy wynikające ze współdzielonego stanu wymagają lepszej izolacji i kontrolowanego przygotowania danych testowych. Problemy z selektorami mogą wymagać bardziej stabilnych locatorów lub dodatkowych warstw abstrakcji. Natomiast błędy powodowane przez zależności zewnętrzne mogą wymagać wykorzystania mocków, kontrolowanych środowisk testowych lub innych metod ograniczających niepotrzebną zmienność.
Zespoły powinny również gromadzić wystarczającą ilość informacji pozwalających odróżnić defekt aplikacji od błędu testu lub problemu środowiskowego. Trace execution, logi, screenshoty, nagrania, informacje o ruchu sieciowym, szczegóły środowiska oraz wskazanie kroku, na którym wystąpił błąd, znacząco ułatwiają analizę i odtwarzanie problemów występujących nieregularnie.
6.2 Regularnie przeglądaj i porządkuj test suite
Testy automatyczne powinny być oceniane przez cały cykl życia produktu. Zmiany w aplikacji mogą sprawiać, że niektóre testy stają się zbędne, duplikują istniejące pokrycie lub tracą wartość biznesową. Utrzymywanie wszystkich testów bez wyjątku zwiększa czas wykonywania test suite i nakład pracy związany z maintenance, niekoniecznie poprawiając jakość release’ów.
Dobrze zdefiniowany proces maintenance powinien obejmować przegląd flaky tests, usuwanie nieaktualnych scenariuszy, eliminowanie zduplikowanego pokrycia oraz ponowną ocenę testów, których wartość biznesowa lub stabilność techniczna uległy zmianie. Częstotliwość takich przeglądów powinna być dostosowana do wielkości test suite, częstotliwości wydań, poziomu ryzyka i skali zmian w produkcie.
Każdy test po przeglądzie powinien mieć jasno określony dalszy los. Może zostać naprawiony, przepisany, przeniesiony do bardziej odpowiedniej warstwy testowania, czasowo wyłączony z przypisanym właścicielem lub usunięty, jeśli nie dostarcza już wartościowych informacji.
6.3 Monitoruj kondycję automatyzacji i koszty utrzymania
Sam pass rate nie wystarczy, aby ocenić kondycję automatyzacji. Zespoły powinny monitorować również powtarzalność błędów, częstotliwość ponownych uruchomień testów, czas wykonywania test suite, nakład pracy związany z maintenance, liczbę nieaktualnych testów, poziom zduplikowanego pokrycia oraz czas potrzebny na analizę i naprawę błędów.
Takie wskaźniki pomagają odróżnić rozrastający się zestaw automatyzacji od automatyzacji, którą można skutecznie utrzymywać w długim okresie. Dodawanie kolejnych testów zwiększa wartość tylko wtedy, gdy zespół rozumie wyniki, potrafi utrzymywać testy i ufa informacjom dostarczanym przez każde wykonanie.
Równie ważna jest traceability zmian w automatyzacji. Zespół powinien mieć wgląd w to, co zostało zmienione, dlaczego test został zaktualizowany, jak przebiegał proces review oraz czy zmodyfikowany test nadal weryfikuje pierwotne wymaganie biznesowe.
Podejście oparte na zarządzaniu pełnym cyklem życia automatyzacji opisaliśmy szerzej w naszym przewodniku dotyczącym najlepszych praktyk QA w testowaniu oprogramowania.
7. Traktuj kod automatyzacji tak jak kod produkcyjny
Kod testów automatycznych powinien podlegać tym samym standardom co kod aplikacji. Testy wymagają jasno określonego ownership, kontroli wersji, spójnych zasad organizacji repozytorium, procesu review oraz quality gates. Bez tych praktyk automatyzacja z czasem staje się coraz trudniejsza do zrozumienia, rozwijania i utrzymywania.
Ownership powinien obejmować zarówno warstwę biznesową, jak i techniczną. Specjaliści QA mogą odpowiadać za definiowanie scenariuszy, oczekiwanych rezultatów i zakresu pokrycia testowego, natomiast Automation Engineers lub developerzy powinni weryfikować, czy kod testów jest zgodny ze standardami projektu i może być utrzymywany w ramach istniejącego frameworka.
Niezależnie od tego, czy testy są tworzone ręcznie, czy generowane przy wsparciu narzędzi automatyzujących, powinny trafiać do repozytorium poprzez standardowy proces pull request lub merge request. Osoby przeprowadzające review powinny mieć możliwość sprawdzenia, co dokładnie weryfikuje dany test, w jaki sposób komunikuje się z aplikacją, z jakich komponentów współdzielonych korzysta oraz czy nie wprowadza niestabilnych zależności lub zduplikowanego pokrycia testowego.
Gdy dla organizacji istotne są kwestie ownership i przenośności rozwiązań, wygenerowane testy nie powinny pozostawać wyłącznie w zamkniętym, proprietarnym środowisku wykonawczym. Przechowywanie automatyzacji w repozytorium klienta zapewnia pełną widoczność zmian, możliwość przeprowadzenia review oraz objęcie testów tymi samymi zasadami governance, które obowiązują pozostałe zasoby projektu.
Zespoły powinny również jasno określić, kto odpowiada za reakcję na sytuację, w której test staje się niestabilny lub nieaktualny. Wyraźnie zdefiniowany ownership pozwala uniknąć sytuacji, w której błędne testy pozostają nierozwiązane, ponieważ zespoły QA, developmentu i automatyzacji zakładają, że odpowiedzialność spoczywa po stronie kogoś innego.
8. Gdzie w tym procesie wpisuje się AI
AI coraz częściej wspiera te praktyki — pomagając tworzyć przypadki testowe na podstawie wymagań, weryfikować proponowaną ścieżkę przed wygenerowaniem kodu czy wskazywać testy, które prawdopodobnie staną się niestabilne. To zagadnienie wykracza poza zakres praktyk opisanych powyżej i dotyczy raczej strategii, doboru narzędzi oraz governance, dlatego omawiamy je szczegółowo w osobnym artykule: AI w automatyzacji testów oprogramowania: przewodnik 2026.
9. Najczęstsze błędy w automatyzacji testów, których warto unikać
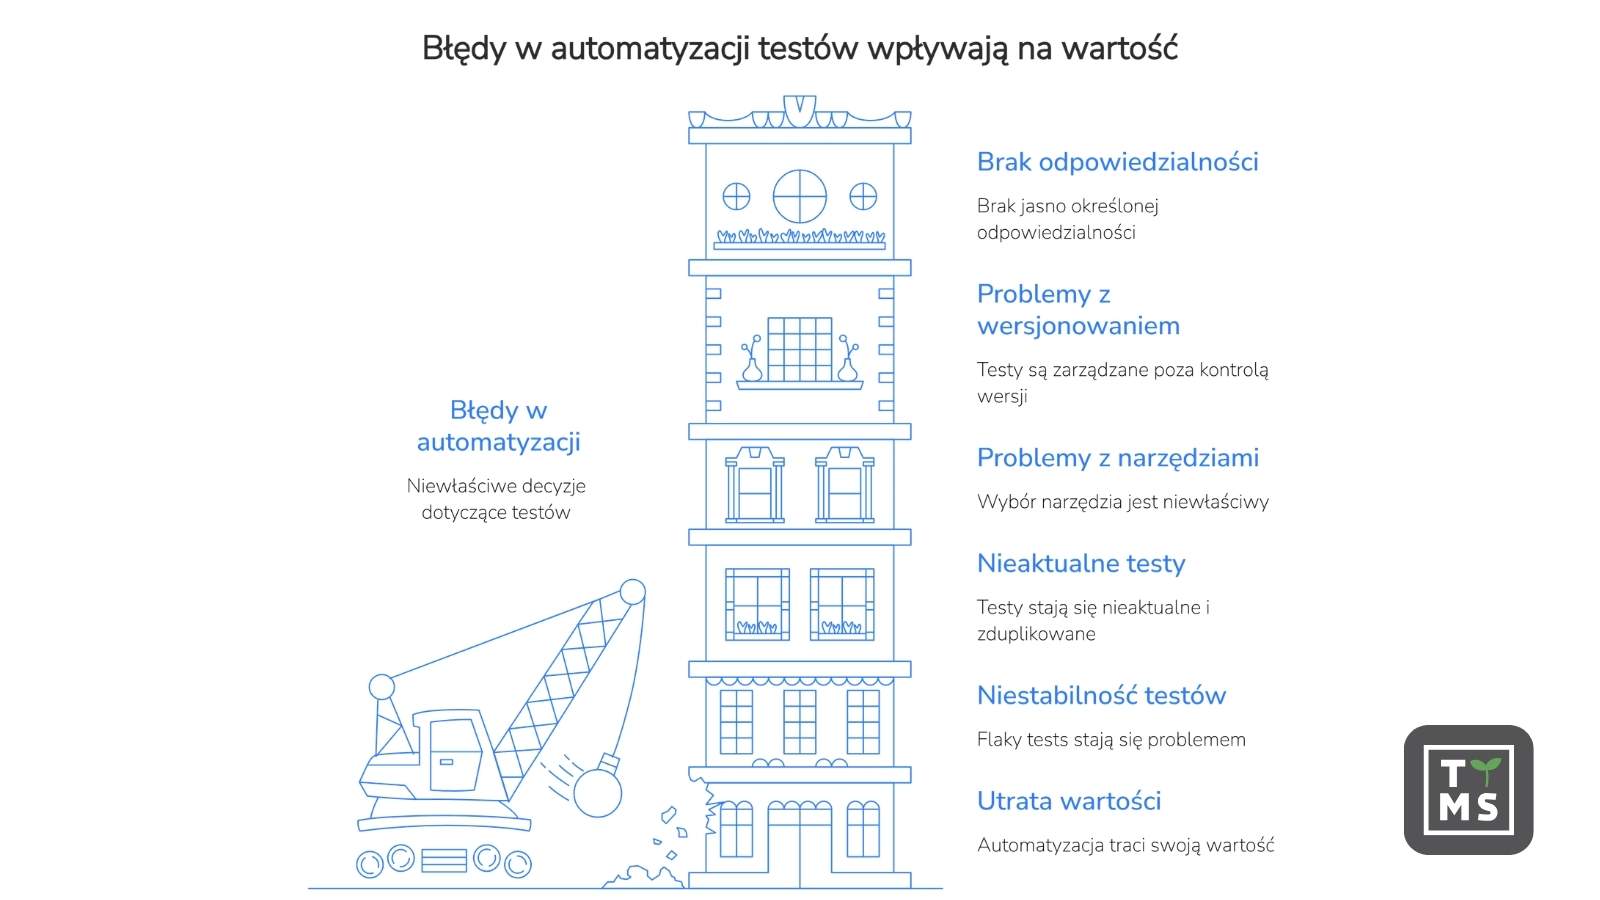
Nawet dobrze zaprojektowana automatyzacja może z czasem tracić swoją wartość, jeśli zespoły podejmują niewłaściwe decyzje dotyczące zakresu testów, ownership czy utrzymania. Do najczęstszych błędów należą:
- Automatyzowanie wszystkich możliwych scenariuszy zamiast skupienia się na testach powtarzalnych, stabilnych i krytycznych z punktu widzenia biznesu.
- Traktowanie ponownego uruchamiania testów jako stałego rozwiązania problemu flaky tests zamiast analizowania rzeczywistych przyczyn ich niestabilności.
- Pozostawianie w test suite nieaktualnych lub zduplikowanych testów bez regularnych przeglądów.
- Wybór narzędzia wyłącznie na podstawie liczby funkcji, bez uwzględnienia integracji, utrzymania, wdrożeń, ownership kodu oraz dopasowania do kompetencji zespołu.
- Generowanie automatyzacji bez wcześniejszej weryfikacji, czy dany scenariusz faktycznie działa w testowanej aplikacji.
- Akceptowanie wygenerowanych testów bez sprawdzenia, czy odzwierciedlają rzeczywiste wymagania i oczekiwane zachowanie biznesowe.
- Przechowywanie automatyzacji wyłącznie w zamkniętym, proprietarnym środowisku, gdy organizacja wymaga przenośnego i podlegającego review kodu we własnym repozytorium.
- Zarządzanie testami poza standardowymi procesami version control, code review i quality gates w CI/CD.
- Brak jasno określonej odpowiedzialności za cel testu, jakość kodu oraz bieżące utrzymanie automatyzacji.
Unikanie tych błędów wymaga czegoś więcej niż wdrożenia kolejnych narzędzi lub napisania większej liczby skryptów. Skuteczna automatyzacja opiera się na kontrolowanym procesie, który łączy wymagania biznesowe, projektowanie testów, wyniki wykonania, kod automatyzacji, review oraz maintenance w jeden spójny workflow.
10. Jak Qatana wykorzystuje najlepsze praktyki automatyzacji testów?
Qatana łączy opisane wcześniej praktyki w ramach agentowej platformy do automatyzacji testów. Rozwiązanie przekształca wymagania zapisane w Jira lub GitLab w gotowe do automatyzacji przypadki testowe, weryfikuje proponowaną ścieżkę użytkownika poprzez wykonanie testu w Playwright, a następnie generuje standardowy kod Playwright dostarczany w formie gotowego do review merge requestu.
Zespół QA zachowuje kontrolę nad celem i zakresem testu, podczas gdy część techniczna może zostać zweryfikowana przez inżynierów w ramach istniejącego procesu merge request review. Wyniki wykonania testów pozostają powiązane z wymaganiem, przypadkiem testowym oraz kodem, zapewniając pełną traceability w całym workflow.
Qatana działa w pełni on-premise i wspiera wykorzystanie wybranego przez organizację modelu LLM, dzięki czemu kontekst projektu, wygenerowany kod oraz dane testowe pozostają w środowisku klienta.
Umów demo i zobacz, jak Qatana zamienia wymagania biznesowe w automatyzację opartą na Playwright.
11. FAQ – Najczęściej zadawane pytania
Jaką część test suite warto zautomatyzować?
Nie istnieje jeden uniwersalny wskaźnik. W pierwszej kolejności warto automatyzować scenariusze stabilne, powtarzalne i krytyczne biznesowo, pozostawiając exploratory testing oraz testy wymagające oceny człowieka w obszarze testów manualnych.
Jaka jest różnica między strategią automatyzacji a frameworkiem?
Strategia automatyzacji określa, co, dlaczego i w jaki sposób powinno zostać zautomatyzowane oraz jak będzie mierzony sukces tych działań. Framework stanowi natomiast techniczną podstawę służącą do tworzenia, uruchamiania i utrzymywania testów automatycznych.
Jak ocenić, czy ROI z automatyzacji jest dodatnie?
Warto porównać czas i koszty zaoszczędzone dzięki automatyzacji z kosztami jej wdrożenia, wykonywania i utrzymania. Jeżeli nakład pracy związany z maintenance regularnie przewyższa uzyskiwane korzyści, należy ponownie ocenić dobór testów oraz przyjęte podejście do automatyzacji.
Jaka jest najczęstsza przyczyna tego, że program automatyzacji „utyka” po pierwszym pilotażu?
Zwykle nie jest to problem narzędziowy, tylko brak ciągłego ownership. Zespoły z sukcesem automatyzują pierwszą partię testów, ale bez zdefiniowanego cyklu utrzymania, jasno przypisanej odpowiedzialności za kod oraz procesu review w repozytorium, suite szybciej obrasta w niestabilne i nieaktualne testy, niż ktokolwiek zdąży je naprawić — a zaufanie do wyników automatyzacji spada.