
Home •Blog
TTMS Blog
Świat okiem ekspertów IT.
Sortuj po tematach
AI w automatyzacji testów – przewodnik na 2026 rok
AI w automatyzacji testów przestaje być eksperymentalnym dodatkiem i coraz częściej staje się częścią codziennych procesów QA i software delivery. Zespoły wykorzystują je do wspierania projektowania testów, weryfikacji scenariuszy, generowania kodu automatyzacji, analizy wyników wykonania oraz ograniczania ilości powtarzalnej pracy związanej z utrzymaniem testów. Sama obecność AI nie gwarantuje jednak lepszych rezultatów. Kluczowe znaczenie ma sposób wdrożenia tych możliwości oraz odpowiedni governance całego procesu. W tym przewodniku pokazujemy, w których obszarach cyklu życia automatyzacji testów AI może realnie wspierać zespoły, jakie czynniki warto ocenić przed wdrożeniem platformy AI test automation oraz jak zachować kontrolę nad celem testów, generowanym kodem, wynikami wykonania i dalszym rozwojem automatyzacji. 1. AI w automatyzacji testów – dlaczego ma tak duże znaczenie w 2026 roku? Wraz ze wzrostem złożoności aplikacji i procesów software delivery automatyzacja testów musi obejmować znacznie więcej niż samo wykonywanie wcześniej przygotowanych skryptów. Zespoły muszą również dbać o zgodność testów ze zmieniającymi się wymaganiami, utrzymywać istniejącą automatyzację, analizować wyniki wykonania oraz podejmować decyzje dotyczące scenariuszy wymagających dodatkowej uwagi. AI może wspierać te działania, łącząc wymagania biznesowe, projektowanie testów, wyniki wykonania, generowanie kodu oraz sygnały związane z utrzymaniem automatyzacji. Największa wartość nie wynika jednak z samej automatyzacji kolejnych zadań, ale z ograniczania powtarzalnej pracy przy jednoczesnym zachowaniu jasnego ownership, procesu review oraz traceability w całym cyklu życia testów. Dla organizacji wdrażających AI w automatyzacji testów kluczowym celem w 2026 roku powinno być budowanie kontrolowanego workflow, a nie dodawanie pojedynczych funkcji opartych na AI. Generowane rezultaty wymagają wiarygodnego kontekstu projektowego, weryfikacji opartej na rzeczywistym wykonaniu, jasno zdefiniowanych punktów akceptacji oraz integracji z istniejącymi repozytoriami i procesami CI/CD. 2. Czym jest AI w automatyzacji testów? AI w automatyzacji testów oznacza wykorzystanie takich technologii jak natural language processing (NLP), analiza kontekstowa, rozpoznawanie wzorców oraz agenci AI do wspierania tworzenia, wykonywania, weryfikacji i utrzymania testów automatycznych. W zależności od platformy AI może wspierać różne etapy cyklu życia automatyzacji testów, od interpretacji wymagań biznesowych po generowanie i utrzymanie testów automatycznych. 2.1 Czym AI-powered testing różni się od tradycyjnej automatyzacji testów? Tradycyjna automatyzacja testów polega na wykonywaniu wcześniej przygotowanych skryptów zgodnie ze zdefiniowanymi krokami, warunkami i asercjami. Takie podejście zapewnia przewidywalność i pełną kontrolę techniczną, jednak tworzenie i utrzymanie testów często wymaga znacznego zaangażowania zespołów inżynierskich, zwłaszcza gdy zmieniają się wymagania, interfejs użytkownika, dane testowe lub zachowanie aplikacji. AI-powered testing dodaje do tego procesu dodatkową warstwę kontekstu. AI może analizować wymagania, wykorzystywać wiedzę o projekcie do przygotowywania scenariuszy testowych, wspierać weryfikację opartą na rzeczywistym wykonaniu testu, generować kod automatyzacji oraz analizować wyniki kolejnych uruchomień. W zależności od sposobu implementacji może również identyfikować niestabilne testy, sugerować aktualizacje lub wskazywać luki w pokryciu testowym. Różnica nie polega na tym, że AI eliminuje skrypty lub udział człowieka. Workflow wspierane przez AI mogą ograniczać ilość pracy wykonywanej pomiędzy pojawieniem się wymagania a powstaniem działającej automatyzacji, przy jednoczesnym zachowaniu kontroli zespołu QA nad celem testu oraz kontroli zespołu technicznego nad kodem trafiającym do repozytorium. 3. W których obszarach AI wspiera cykl życia automatyzacji testów? AI w automatyzacji testów nie oznacza jednej konkretnej funkcji. Może wspierać różne etapy procesu testowego, dlatego warto analizować poszczególne możliwości oddzielnie. Takie podejście ułatwia ocenę platform AI test automation i pozwala określić, gdzie AI rzeczywiście przynosi wartość, bez utraty kontroli ze strony zespołu QA i inżynierów. 3.1 Analiza wymagań i projektowanie testów AI może przekształcać wymagania, acceptance criteria, tickety oraz istniejącą wiedzę zespołów QA w uporządkowane scenariusze testowe. Ogranicza to ilość pracy potrzebnej do przełożenia wymagań biznesowych na szczegółowe przypadki testowe, a jednocześnie pomaga identyfikować brakujące warunki początkowe, oczekiwane rezultaty czy alternatywne ścieżki wykonania. Jakość wygenerowanych rezultatów zależy jednak od dostępnego kontekstu projektowego. Z tego powodu wygenerowane testy powinny pozostawać możliwe do review i wyraźnie rozróżniać informacje potwierdzone od obszarów wymagających dodatkowej weryfikacji przez QA lub interesariuszy biznesowych. 3.2 Weryfikacja oparta na rzeczywistym wykonaniu Scenariusz wygenerowany przez AI może wyglądać poprawnie, a mimo to nie być możliwy do wykonania w rzeczywistej aplikacji. Weryfikacja oparta na wykonaniu scenariusza pozwala agentowi AI odtworzyć proponowane kroki, przeanalizować zachowanie aplikacji, zidentyfikować odpowiednie elementy interfejsu i sprawdzić, czy oczekiwany rezultat faktycznie można osiągnąć. Dzięki temu jeszcze przed wygenerowaniem kodu powstają techniczne dowody potwierdzające poprawność scenariusza. Nadal jednak to zespół QA powinien potwierdzić, że zweryfikowana ścieżka odpowiada właściwemu procesowi biznesowemu. 3.3 Generowanie kodu automatyzacji AI może wykorzystywać założenia testu oraz dane zebrane podczas weryfikacji do generowania kodu automatyzacji. Wygenerowany kod powinien być zgodny ze standardami obowiązującymi w projekcie, wykorzystywać istniejące komponenty wielokrotnego użytku i pozostać czytelny dla zespołu technicznego. Kod generowany przez AI powinien przechodzić standardowy proces testowania oraz trafiać do repozytorium poprzez istniejący workflow oparty na kontroli wersji i review. Dzięki temu automatyzacja pozostaje przejrzysta, możliwa do zweryfikowania i łatwa w utrzymaniu zamiast funkcjonować wyłącznie w zamkniętym środowisku dostawcy. 3.4 Utrzymanie i optymalizacja testów wspierane przez AI AI może analizować historię wykonań testów, powtarzające się błędy, niestabilne asercje, zmiany locatorów oraz nakładające się pokrycie testowe, aby wskazywać obszary wymagające uwagi. Na tej podstawie system może rekomendować naprawę testów, konsolidację istniejącej automatyzacji lub usunięcie scenariuszy, które nie dostarczają już wartości. Istotne zmiany powinny jednak pozostawać widoczne i podlegać review. Test zmodyfikowany automatycznie może nadal przechodzić poprawnie, a jednocześnie przestać weryfikować pierwotne wymaganie biznesowe. Dlatego decyzje związane z utrzymaniem wymagają jasno określonego ownership i procesu akceptacji. 3.5 Raportowanie, traceability i review AI może pomagać w porządkowaniu wyników wykonania testów oraz łączeniu ich z odpowiednimi wymaganiami, przypadkami testowymi, zmianami w kodzie i decyzjami podjętymi podczas review. Dzięki temu zespoły QA i engineering zyskują lepszą widoczność tego, co zostało przetestowane, w jaki sposób powstała automatyzacja oraz dlaczego została zmodyfikowana. W środowiskach enterprise szczególnie ważne jest, aby użytkownicy mogli analizować dane wejściowe wykorzystywane przez AI, wygenerowane rezultaty, wyniki wykonania testów oraz decyzje reviewerów, zamiast polegać na nieprzejrzystym i trudnym do zweryfikowania procesie automatyzacji. 4. Jak AI wnosi wartość biznesową w automatyzacji testów? AI wnosi wartość biznesową w automatyzacji testów przede wszystkim poprzez skrócenie czasu potrzebnego na przejście od wymagania do gotowej automatyzacji poddanej review. Może ograniczyć ilość pracy związanej z analizą ticketów, przygotowywaniem scenariuszy testowych, przekształcaniem założeń testu w kod oraz analizą wyników wykonania. Dzięki temu specjaliści QA mogą w większym stopniu wykorzystywać swoją wiedzę domenową podczas projektowania testów, a zespoły inżynierskie mogą skupić się na review technicznym i utrzymaniu standardów obowiązujących w repozytorium zamiast tworzyć każdy test od podstaw. Efektem może być szybsze dostarczanie automatyzacji bez konieczności angażowania wielu osób na każdym etapie procesu. Dodatkową korzyścią jest większa traceability, która pozwala śledzić, w jaki sposób wymaganie biznesowe zostało przekształcone w automatyzację oraz czy kolejne zmiany nadal odzwierciedlają pierwotne założenia testu. Wartość biznesowa AI zależy jednak od jakości wdrożenia. Wygenerowane rezultaty nadal wymagają wiarygodnego kontekstu projektowego, weryfikacji opartej na rzeczywistym wykonaniu, jasno określonego ownership oraz review przed dodaniem testów do test suite. Organizacje powinny oceniać skuteczność wdrożenia AI na podstawie takich wskaźników jak ograniczenie pracy wykonywanej manualnie, skrócenie czasu od pojawienia się wymagania do powstania automatyzacji poddanej review, poziom akceptacji generowanego kodu, zmniejszenie nakładu pracy związanego z maintenance oraz poprawa jakości i niezawodności wyników testów. 5. Jak ocenić i wdrożyć platformę AI do automatyzacji testów? Wybór platformy AI test automation wymaga znacznie więcej niż porównania listy funkcji. Rozwiązanie powinno być dopasowane do istniejącego workflow zarządzania wymaganiami, wykorzystywanych frameworków automatyzacji, repozytoriów, procesów CI/CD, wymagań bezpieczeństwa oraz kompetencji zespołu. Punktem wyjścia powinien być proces, który organizacja chce usprawnić. Platforma skupiająca się wyłącznie na generowaniu przypadków testowych może nie rozwiązać szerszego problemu, jakim jest przekształcanie wymagań w wykonywalną i łatwą w utrzymaniu automatyzację. Dlatego warto ocenić, w jaki sposób narzędzie obsługuje projektowanie testów, weryfikację opartą na wykonaniu, generowanie kodu, review, raportowanie oraz późniejsze utrzymanie automatyzacji. 5.1 Najważniejsze kryteria wyboru platformy AI test automation Przy ocenie narzędzia warto zwrócić uwagę na kilka kluczowych obszarów: Integracja z wymaganiami – czy platforma potrafi wykorzystywać tickety, acceptance criteria i istniejącą wiedzę QA jako kontekst do tworzenia testów? Model weryfikacji – czy przed wygenerowaniem automatyzacji weryfikuje proponowany scenariusz na rzeczywistej aplikacji? Code ownership – czy wygenerowane testy pozostają dostępne jako standardowy kod w repozytorium organizacji? Review i governance – czy zespół może analizować dane wejściowe AI, wygenerowane rezultaty, wyniki wykonania oraz decyzje podjęte podczas review? Zgodność z frameworkami – czy platforma wspiera technologie automatyzacji wykorzystywane już w organizacji? Dopasowanie do repozytorium – czy generowany kod przestrzega istniejących standardów dotyczących fixtures, helperów, hooków, nazewnictwa i jakości kodu? Deployment i kontrola danych – czy rozwiązanie może działać zgodnie z wymaganiami infrastrukturalnymi oraz modelem governance AI obowiązującym w organizacji? Maintainability – czy platforma wykorzystuje dane z wykonania testów do identyfikowania niestabilnej, nieaktualnej lub zbędnej automatyzacji? Dopasowanie do zespołu – czy QA może definiować i weryfikować cel testu, podczas gdy zespoły techniczne zachowują kontrolę nad jakością kodu? To właśnie te kryteria pozwalają odróżnić kompletny workflow AI test automation od rozwiązania ograniczającego się wyłącznie do generowania testów. 5.2 Jak włączyć AI testing do istniejącego CI/CD? Platforma AI test automation powinna współpracować z istniejącymi procesami version control i CI/CD. Wygenerowana automatyzacja powinna trafiać do repozytorium poprzez standardowy workflow oparty na pull requestach lub merge requestach, gdzie może zostać poddana review, uruchomiona i zatwierdzona przed połączeniem zmian z główną gałęzią projektu. Wyniki wykonania testów powinny być następnie powiązane z odpowiednią zmianą w kodzie, przypadkiem testowym oraz źródłem wymagania. Takie podejście zapewnia pełną traceability pomiędzy celem testu, wygenerowanym kodem, dowodami wykonania oraz decyzjami podejmowanymi podczas procesu release. Integracja platformy może wymagać dostępu do repozytoriów, środowisk wykonawczych, poświadczeń dostępowych, konfiguracji pipeline’ów oraz dodatkowych etapów akceptacji. Warto uwzględnić te wymagania już podczas planowania wdrożenia, zamiast zakładać, że nowe rozwiązanie można dodać do istniejącej architektury delivery bez żadnych zmian. 6. Jak wdrożyć AI test automation z odpowiednimi mechanizmami kontroli? Skuteczna strategia wdrożenia AI test automation powinna zaczynać się od jednego, jasno zdefiniowanego workflow, a nie od próby zautomatyzowania całego procesu testowego jednocześnie. Warto wybrać powtarzalną i krytyczną biznesowo ścieżkę użytkownika, określić obecny nakład pracy związany z jej testowaniem oraz zdefiniować, jakie rezultaty ma przynieść wdrożenie. Najlepiej rozpocząć od wymagań i przypadków testowych posiadających jasno określone warunki początkowe, kroki oraz oczekiwane rezultaty. Jakość wyników generowanych przez AI jest bezpośrednio zależna od jakości dostępnego kontekstu, dlatego przed skalowaniem rozwiązania warto uporządkować niekompletne wymagania oraz niespójne standardy testowania. Od początku należy również zdefiniować ownership oraz proces akceptacji. Zespół QA powinien zachować odpowiedzialność za cel testu i jego wartość biznesową, natomiast Automation Engineerowie lub developerzy powinni weryfikować wygenerowany kod, jego zgodność z repozytorium oraz jakość techniczną. Automatyzacja generowana przez AI nie powinna trafiać do test suite bez wcześniejszej weryfikacji opartej na wykonaniu scenariusza oraz wymaganej akceptacji człowieka. Wdrożenie powinno obejmować również działania techniczne i organizacyjne niezbędne do integracji platformy z repozytoriami, środowiskami wykonawczymi, procesami CI/CD, wykorzystywanymi modelami AI oraz istniejącymi procesami raportowania. Na końcu warto monitorować praktyczne efekty wdrożenia, takie jak czas potrzebny do przejścia od wymagania do automatyzacji poddanej review, liczbę wygenerowanych testów zaakceptowanych bez większych zmian, nakład pracy związany z maintenance, liczbę powtarzających się błędów oraz poziom adopcji rozwiązania przez użytkowników. Dopiero gdy pierwszy workflow stanie się stabilny, zrozumiały i łatwy do utrzymania, warto rozszerzać wykorzystanie AI na kolejne obszary. Takie podejście zmienia sposób współpracy pomiędzy zespołami QA, automatyzacji i engineeringu. Temat ten szerzej omawiamy w naszym przewodniku o tym, jak AI zmienia pracę developerów, testerów i analityków. 7. Wyzwania i ograniczenia AI w automatyzacji testów Skuteczność AI w automatyzacji testów w dużej mierze zależy od jakości wymagań, dostępnego kontekstu projektowego, danych testowych oraz standardów obowiązujących w repozytorium. Niekompletne lub niespójne informacje wejściowe mogą prowadzić do tworzenia scenariuszy, które są technicznie poprawne i możliwe do wykonania, ale nie odzwierciedlają zamierzonego zachowania biznesowego. Weryfikacja oparta na rzeczywistym wykonaniu scenariusza może potwierdzić, że dana ścieżka działa w aplikacji, jednak sama w sobie nie jest w stanie ocenić, czy odpowiada ona właściwemu celowi testowemu. To nadal zadanie zespołu QA, który powinien zweryfikować scenariusz, oczekiwany rezultat oraz zgodność z pierwotnym wymaganiem. Wygenerowana automatyzacja często wymaga również dostosowania do specyfiki projektu, w tym wykorzystywanych fixtures, helperów, mechanizmów uwierzytelniania, sposobu przygotowania danych testowych czy standardów kodowania. Z tego względu organizacje powinny traktować AI test automation jako proces wymagający wdrożenia i review, a nie rozwiązanie typu plug-and-play. Dodatkowe wymagania wynikają również z kwestii bezpieczeństwa i governance. Organizacje potrzebują jasnych zasad dotyczących deploymentu, wykorzystania modeli AI, dostępu do danych, zarządzania wygenerowanym kodem oraz akceptacji zmian wspieranych przez AI, szczególnie w przypadku systemów krytycznych biznesowo lub podlegających regulacjom. Najskuteczniejsze wdrożenia wykorzystują AI do ograniczania powtarzalnej pracy, jednocześnie pozostawiając odpowiedzialność za cel testu, jakość kodu i decyzje release’owe po stronie zespołów QA i engineeringu. Jeśli chcesz szerzej poznać temat risk-based testing, traceability oraz governance procesów jakościowych, zajrzyj również do naszego przewodnika po najlepszych praktykach QA w testowaniu oprogramowania. 8. Jak Qatana łączy AI test automation w jeden kontrolowany workflow Qatana integruje projektowanie testów, weryfikację opartą na wykonaniu, generowanie kodu, review oraz utrzymanie automatyzacji w ramach jednego agentowego workflow. Proces rozpoczyna się od wymagań zapisanych w Jira lub GitLab, które są przekształcane w gotowe do automatyzacji przypadki testowe. Następnie Qatana weryfikuje proponowaną ścieżkę użytkownika poprzez wykonanie jej w Playwright, jeszcze przed wygenerowaniem kodu automatyzacji. Powstały kod Playwright jest dostarczany w postaci gotowego do review merge requestu. Zespół QA zachowuje kontrolę nad celem i zakresem testu, natomiast inżynierowie mogą przeprowadzić techniczną weryfikację rozwiązania w ramach istniejącego procesu kontroli wersji obowiązującego w organizacji. Wyniki wykonania pozostają powiązane z wymaganiem, przypadkiem testowym, kodem oraz historią review, zapewniając pełną traceability całego procesu. Qatana wykorzystuje również wyniki wykonania testów, sygnały z CI/CD oraz feedback pochodzący z review do wspierania utrzymania i optymalizacji automatyzacji. Platforma działa w całości on-premise i wspiera wybrany przez organizację model LLM, dzięki czemu kontekst projektu, wygenerowany kod oraz dane z wykonania testów pozostają w kontrolowanym środowisku klienta. Umów demo i zobacz, jak Qatana zamienia wymagania biznesowe w zweryfikowaną podczas wykonania automatyzację opartą na Playwright. 9. Najczęściej zadawane pytania dotyczące AI w automatyzacji testów Czy AI może całkowicie zastąpić testerów manualnych? Nie. AI może wspierać projektowanie testów, wykonywanie testów, generowanie kodu oraz utrzymanie automatyzacji, ale to testerzy nadal odpowiadają za definiowanie celu biznesowego testów, ocenę wygenerowanych rezultatów oraz wykonywanie exploratory testing, które wymaga ludzkiej wiedzy, doświadczenia i oceny. W jaki sposób AI wspiera self-healing test automation? AI może wykrywać zmiany wpływające na działanie testów automatycznych oraz sugerować lub generować aktualizacje na podstawie danych z wykonania testów. Istotne zmiany powinny jednak pozostawać widoczne i wymagać review, aby mieć pewność, że test nadal weryfikuje właściwe zachowanie aplikacji. Czy AI-driven testing sprawdza się w branżach regulowanych? Tak, pod warunkiem że platforma zapewnia odpowiedni poziom governance, traceability, kontroli dostępu oraz ochrony danych. Organizacje powinny również ocenić sposób wdrożenia rozwiązania, kontrolę nad wykorzystywanymi modelami AI, możliwości audytowe oraz zgodność z własnymi wymaganiami regulacyjnymi. Jakich kompetencji potrzebują zespoły QA, aby pracować z narzędziami AI testing? Kluczowe znaczenie mają umiejętności związane z projektowaniem testów, znajomość domeny biznesowej oraz zdolność do weryfikacji scenariuszy i wyników generowanych przez AI. Pomocna jest również znajomość workflow automatyzacji, repozytoriów kodu oraz ograniczeń i możliwości technologii AI.
Czytaj
Walidacja systemów SaaS w farmacji i wymagania GxP
System SaaS może wspierać proces jakościowy, badania laboratoryjne, produkcję, dystrybucję albo badania kliniczne bez utrzymywania aplikacji we własnym centrum danych. Model chmurowy nie usuwa jednak odpowiedzialności regulowanej firmy za sposób wykorzystania systemu. Jeżeli aplikacja przetwarza dane GxP, wpływa na jakość produktu, bezpieczeństwo pacjenta lub decyzje regulowane, organizacja musi wykazać, że rozwiązanie jest odpowiednie do zamierzonego zastosowania i pozostaje pod kontrolą przez cały cykl życia. Walidacja systemów SaaS w farmacji różni się od klasycznego projektu wdrożeniowego. Dostawca odpowiada za część platformy, publikuje aktualizacje według własnego harmonogramu i może korzystać z podwykonawców. Klient konfiguruje procesy, role, dane, integracje i sposób użycia. Zakres odpowiedzialności jest więc podzielony, ale odpowiedzialność regulacyjna za proces GxP pozostaje po stronie organizacji korzystającej z systemu. W artykule wyjaśniamy, kiedy system SaaS wymaga walidacji, jak zbudować strategię opartą na ryzyku, jakich dowodów oczekiwać od dostawcy i jak utrzymać stan zwalidowany przy częstych wydaniach oprogramowania. Materiał dotyczy przede wszystkim środowiska GMP, ale wiele opisanych zasad można zastosować także w obszarach GLP, GCP, GDP i farmakowigilancji po uwzględnieniu właściwych przepisów oraz procedur organizacji. 1. Czym jest walidacja systemu SaaS w środowisku GxP Walidacja systemu skomputeryzowanego dostarcza udokumentowanych dowodów, że system spełnia zatwierdzone wymagania użytkownika, działa zgodnie z zamierzonym zastosowaniem i jest kontrolowany w sposób proporcjonalny do ryzyka. W modelu SaaS przedmiotem oceny nie jest sam produkt dostawcy w oderwaniu od organizacji. Walidowany jest konkretny sposób wykorzystania aplikacji, obejmujący konfigurację, procesy, dane, interfejsy, role użytkowników i procedury operacyjne. Ten sam system może mieć odmienny status w dwóch firmach. W pierwszej służy wyłącznie do organizacji spotkań, a w drugiej zatwierdza specyfikacje, przechowuje wyniki badań lub generuje zapis wykorzystywany przy zwolnieniu serii. Nazwa produktu i deklaracje producenta nie przesądzają więc o zakresie walidacji. Decydują zamierzone zastosowanie, znaczenie danych i wpływ funkcji na regulowany proces. W praktyce walidacja powinna odpowiedzieć na cztery pytania: czy wymagania biznesowe i regulacyjne zostały jednoznacznie określone; czy ryzyka dla pacjenta, produktu i integralności danych są rozpoznane i kontrolowane; czy konfiguracja oraz krytyczne procesy zostały skutecznie przetestowane; czy organizacja potrafi utrzymać kontrolę po uruchomieniu systemu. Walidacja nie jest certyfikatem nadawanym aplikacji raz na zawsze. Jest stanem opartym na dowodach dotyczących konkretnej wersji, konfiguracji i sposobu użycia, a następnie podtrzymywanym przez zarządzanie zmianami, incydentami, dostępem i okresowe przeglądy. 2. Kiedy system SaaS podlega wymaganiom GxP Pierwszym krokiem nie powinno być zamówienie pełnego pakietu testów, lecz klasyfikacja systemu i jego funkcji. Należy ustalić, czy rozwiązanie tworzy, zmienia, przechowuje, przesyła lub raportuje dane wykorzystywane w działalności regulowanej. Istotne jest również to, czy awaria, błędna konfiguracja albo nieautoryzowana zmiana może wpłynąć na jakość produktu, bezpieczeństwo pacjenta, wiarygodność danych lub zgodność procesu. Przykładowe systemy SaaS o potencjalnym znaczeniu GxP obejmują: elektroniczne systemy zarządzania jakością eQMS; systemy zarządzania dokumentacją EDMS i szkoleniami; laboratoryjne systemy LIMS, ELN i platformy zarządzania danymi analitycznymi; systemy wspierające badania kliniczne, bezpieczeństwo leków i nadzór nad przypadkami; aplikacje do zarządzania zmianami, odchyleniami, CAPA i reklamacjami; systemy ERP, planowania i gospodarki magazynowej, jeżeli ich dane wpływają na operacje GxP; platformy do elektronicznych zapisów i podpisów stosowanych w procesach regulowanych. Nie każda funkcja takiego rozwiązania musi być równie krytyczna. Moduł obsługujący zatwierdzenie dokumentu może wymagać bardziej rygorystycznych kontroli niż moduł prezentujący pomocniczy pulpit. Podejście oparte na ryzyku pozwala skupić testy i dokumentację na funkcjach, które rzeczywiście wpływają na chronione dane i decyzje. 2.1 Ocena wpływu GxP Ocena wpływu powinna identyfikować regulowany proces, właściciela biznesowego, rodzaje zapisów, decyzje podejmowane na podstawie danych oraz możliwe skutki błędu. Samo oznaczenie aplikacji jako „GxP” albo „non GxP” jest zbyt ogólne, jeżeli system obsługuje wiele procesów. Lepszym rozwiązaniem jest analiza funkcji i przepływów danych. Wysoki wpływ mogą mieć funkcje, które: sterują krytycznym etapem procesu lub dostarczają dane do jego zwolnienia; generują, obliczają albo zatwierdzają wynik mający znaczenie dla jakości produktu; utrzymują oryginalne dane, metadane i ścieżkę audytową; zarządzają elektronicznymi podpisami lub zatwierdzeniami; przesyłają dane między systemami bez niezależnej kontroli ich kompletności. Wynik oceny powinien wskazywać, które wymagania są krytyczne, jaki poziom dowodów jest potrzebny i które zmiany będą wymagały ponownej oceny albo testów regresji. 3. Podstawa regulacyjna walidacji SaaS W Polsce wymagania Dobrej Praktyki Wytwarzania wynikają z rozporządzenia Ministra Zdrowia w sprawie wymagań Dobrej Praktyki Wytwarzania wraz z późniejszymi zmianami. Aneks 11 obejmuje systemy skomputeryzowane stosowane w działalności GMP i wymaga, aby aplikacje były walidowane, a infrastruktura IT kwalifikowana. Zakres walidacji oraz kontroli integralności danych powinien wynikać z uzasadnionej i udokumentowanej oceny ryzyka. Na poziomie europejskim podstawowym punktem odniesienia pozostaje EudraLex Volume 4 i EU GMP Annex 11. Aneks nie ustanawia osobnej kategorii prawnej dla SaaS. Model dostarczania nie zwalnia z obowiązków dotyczących walidacji, kwalifikacji dostawcy, bezpieczeństwa, ścieżek audytowych, ciągłości działania, archiwizacji i okresowej oceny. Wytyczne EMA dotyczące GMP i integralności danych odnoszą cykl życia danych również do aplikacji i pamięci masowej w chmurze. Organizacja powinna rozumieć, gdzie powstają dane i metadane, jak są przetwarzane, przenoszone, przechowywane, odzyskiwane i usuwane oraz jakie podmioty mają do nich dostęp. Skalowanie działań walidacyjnych powinno odpowiadać ryzyku. ICH Q9(R1) dotyczący zarządzania ryzykiem jakości wskazuje, że poziom formalności, wysiłku i dokumentacji powinien być współmierny do poziomu ryzyka. Nie oznacza to ograniczania wymaganych kontroli z powodów budżetowych. Oznacza natomiast, że dowody należy dobierać do krytyczności funkcji, złożoności systemu i niepewności. Jeżeli rozwiązanie jest wykorzystywane w procesach podlegających regulacjom amerykańskim, trzeba przeanalizować także zakres 21 CFR Part 11 oraz odpowiednich przepisów bazowych. Wytyczne FDA dotyczące elektronicznych zapisów i podpisów wyjaśniają, że Part 11 dotyczy określonych zapisów elektronicznych utrzymywanych lub przekazywanych na podstawie wymagań FDA. Nie każda funkcja elektroniczna automatycznie podlega Part 11, a sformułowanie „Part 11 compliant” nie zastępuje analizy konkretnego procesu i konfiguracji. GAMP 5 jest powszechnie stosowanym przewodnikiem branżowym pomagającym przełożyć wymagania na cykl życia systemu i podejście oparte na ryzyku. Nie jest jednak przepisem prawa ani certyfikatem produktu. Organizacja powinna określić własną strategię walidacji na podstawie mających zastosowanie regulacji, zamierzonego zastosowania systemu oraz swojego systemu jakości. 4. Odpowiedzialność firmy i dostawcy SaaS W tradycyjnym wdrożeniu organizacja może kontrolować serwery, bazę danych, harmonogram aktualizacji i wiele czynności administracyjnych. W SaaS część tych działań wykonuje dostawca lub jego podwykonawcy. Zmienia to źródło dowodów i mechanizmy nadzoru, ale nie przenosi odpowiedzialności za regulowany proces. Podział odpowiedzialności powinien być zapisany w umowie, umowie jakościowej albo innym kontrolowanym dokumencie. Ogólny regulamin usługi zwykle nie opisuje wszystkich kwestii potrzebnych w środowisku GxP. Obszar Typowa odpowiedzialność dostawcy Odpowiedzialność firmy regulowanej Wymagany dowód Rozwój produktu Kontrolowany cykl rozwoju, testy produktu, zarządzanie defektami Ocena przydatności procesu dostawcy i wykorzystanie dostępnych dowodów Raport z audytu lub kwalifikacji, opis SDLC, podsumowania testów Infrastruktura Hosting, utrzymanie platformy, monitoring, kopie techniczne Ocena modelu usługi, wymagań retencji i odzyskiwania Architektura, zakres odpowiedzialności, wyniki testów odtworzeniowych Konfiguracja Mechanizmy konfiguracji i dokumentacja produktu Zatwierdzenie konfiguracji zgodnej z procesem GxP Specyfikacja konfiguracji, przegląd i testy Dostęp Funkcje zarządzania rolami i uwierzytelnianiem Projekt ról, nadawanie i okresowy przegląd uprawnień Macierz ról, testy, zapisy z przeglądów Aktualizacje Informowanie o wydaniu, testy produktu, wdrożenie zmiany Ocena wpływu, decyzja o testach i zatwierdzenie użycia Release notes, impact assessment, testy regresji Dane Techniczne mechanizmy przechowywania, eksportu i ochrony Klasyfikacja danych, retencja, kontrola kompletności i użycia Mapa danych, testy eksportu, procedury archiwizacji Incydenty Wykrywanie i obsługa zdarzeń po stronie usługi Ocena wpływu GxP, działania jakościowe i decyzje biznesowe Zgłoszenia, RCA, CAPA, zapis decyzji Macierz nie powinna pozostawiać luk ani dublować odpowiedzialności bez wskazania właściciela. Szczególnie ważne są sytuacje, w których dostawca zakłada, że klient testuje daną kontrolę, a klient uważa ją za część standardowej usługi. 5. Walidacja systemów SaaS w farmacji krok po kroku 5.1 Określenie zamierzonego zastosowania Zamierzone zastosowanie opisuje, po co organizacja wdraża system, jakie procesy będzie wspierał, kto będzie z niego korzystał i jakie decyzje będą podejmowane na podstawie danych. Opis powinien być konkretny. Stwierdzenie „system do zarządzania jakością” nie wyjaśnia, czy aplikacja obsługuje dokumenty, CAPA, szkolenia, audyty, podpisy czy wszystkie te funkcje. Na tym etapie należy również określić granice systemu, interfejsy, źródła danych, rekordy GxP i funkcje pozostające poza zakresem. Dobrze zdefiniowana granica ogranicza późniejsze spory dotyczące testów i odpowiedzialności. 5.2 Mapowanie procesu i cyklu życia danych Mapa procesu pokazuje, gdzie dane są tworzone, sprawdzane, zatwierdzane, raportowane i archiwizowane. Dla SaaS trzeba uwzględnić również transfery między usługami, integracje API, warstwy raportowe, kopie zapasowe, eksporty oraz narzędzia administracyjne dostawcy. Analiza powinna obejmować dane oraz metadane potrzebne do odtworzenia zdarzenia. Sama możliwość wyeksportowania pliku PDF nie zawsze wystarczy, jeżeli nie zachowuje historii zmian, podpisów, znaczników czasu, relacji lub kontekstu rekordu. 5.3 Kwalifikacja dostawcy i usługi Kwalifikacja dostawcy powinna być proporcjonalna do krytyczności rozwiązania i stopnia zależności od zewnętrznego podmiotu. Certyfikaty ISO 27001, raporty SOC i wyniki testów bezpieczeństwa mogą stanowić ważne dowody, ale nie potwierdzają automatycznie zgodności konkretnego procesu GxP. Ocena może obejmować: system zarządzania jakością i odpowiedzialności w organizacji dostawcy; cykl rozwoju oprogramowania, testy, przeglądy kodu i obsługę defektów; zarządzanie wersjami, zmianami i komunikacją release notes; bezpieczeństwo, zarządzanie podatnościami i reakcję na incydenty; ciągłość działania, kopie zapasowe i testowanie odtwarzania; nadzór nad podwykonawcami oraz lokalizacje przetwarzania danych; dostępność dokumentacji, wsparcia audytowego i danych po rozwiązaniu umowy. Forma oceny może obejmować kwestionariusz, przegląd dokumentów, zdalny audyt lub audyt na miejscu. Decyzja powinna wynikać z ryzyka, a nie z jednej stałej procedury dla wszystkich dostawców. 5.4 Ustalenie wymagań i kryteriów akceptacji Specyfikacja wymagań użytkownika powinna opisywać potrzebny rezultat i kryteria akceptacji. Wymagania muszą być testowalne i możliwe do prześledzenia. Oprócz funkcji biznesowych warto ująć wymagania dotyczące integralności danych, bezpieczeństwa, audytu, podpisów elektronicznych, retencji, eksportu, wydajności, dostępności i obsługi awarii. Przykładowe wymaganie „system posiada audit trail” jest zbyt ogólne. Należy określić, jakie zdarzenia mają być zapisywane, czy zapis zawiera użytkownika, datę, czas, wartość poprzednią i nową, powód zmiany oraz kto może przeglądać i eksportować historię. 5.5 Ocena ryzyka funkcjonalnego i integralności danych Ocena ryzyka łączy wymagania z możliwymi błędami oraz kontrolami. Dla każdej funkcji warto ustalić, co może pójść źle, jaki będzie skutek, jak błąd może zostać wykryty i które zabezpieczenie ogranicza ryzyko. Krytyczne wymagania powinny otrzymać odpowiednio silne dowody z testów lub innych wiarygodnych źródeł. Nie należy sprowadzać oceny wyłącznie do mechanicznego iloczynu punktów. Uzasadnienie, wiedza procesowa i jakość danych wejściowych są ważniejsze niż pozorna precyzja liczby. Ryzyko trzeba ponownie oceniać po zmianie konfiguracji, procesu, interfejsu albo dostawcy. 5.6 Projekt konfiguracji i kontroli Standardowa konfiguracja SaaS często ogranicza potrzebę tworzenia niestandardowego kodu, ale konfiguracja nadal może decydować o zachowaniu procesu. Statusy, ścieżki zatwierdzeń, reguły eskalacji, role, słowniki, formularze i reguły retencji powinny zostać opisane, przejrzane i kontrolowane. Rozszerzenia, skrypty, automatyzacje i integracje zwiększają zakres odpowiedzialności klienta. Trzeba ustalić ich właścicieli, repozytoria, sposób wdrażania i testowania. Wysoki poziom personalizacji może utrudniać korzystanie ze standardowych dowodów dostawcy. 5.7 Walidacja migracji i interfejsów Migracja danych wymaga potwierdzenia kompletności, dokładności i zachowania znaczenia zapisów. Strategia powinna opisywać reguły mapowania, transformacje, rekordy odrzucone, uzgodnienie liczby obiektów i sposób zatwierdzania wyjątków. Próbkowanie może być właściwe, jeżeli jego zakres wynika z ryzyka i struktury danych. Interfejsy należy testować w obu kierunkach, jeżeli dwukierunkowy przepływ ma znaczenie dla procesu. Testy powinny obejmować poprawne dane, błędy transmisji, duplikaty, ponowienie komunikatu, synchronizację czasu oraz zachowanie systemu po częściowym niepowodzeniu. 5.8 Testowanie krytycznych procesów Testy powinny wykazać spełnienie wymagań i skuteczność kontroli. W SaaS można wykorzystać część dowodów dostawcy, jeżeli organizacja rozumie ich zakres, wersję, środowisko i sposób zatwierdzenia. Nie ma potrzeby bezrefleksyjnie powtarzać każdego testu producenta. Trzeba natomiast samodzielnie potwierdzić własną konfigurację, procesy, role, dane i integracje. Pakiet testów może obejmować: testy pozytywne krytycznych przepływów biznesowych; testy negatywne oraz obsługę wyjątków; testy ról i rozdziału obowiązków; sprawdzenie audit trail i elektronicznych podpisów; testy integralności transferu i migracji danych; testy raportów, obliczeń i eksportów; scenariusze awarii, odzyskiwania i ciągłości procesu; testy akceptacyjne wykonywane przez reprezentatywnych użytkowników. Nazwy IQ, OQ i PQ mogą być używane zgodnie z procedurami organizacji, ale nie powinny zastępować logicznego powiązania wymagań, ryzyk i dowodów. Dla typowego SaaS klasyczna kwalifikacja instalacyjna może w dużej mierze opierać się na dowodach dostawcy, natomiast konfiguracja i zamierzone zastosowanie wymagają oceny po stronie klienta. 5.9 Raport i decyzja o uruchomieniu Raport podsumowujący powinien przedstawiać zakres, wersję i konfigurację systemu, wykonane działania, wyniki testów, odchylenia, pozostałe ryzyka oraz warunki dopuszczenia do użycia. Nierozwiązane odchylenie nie musi automatycznie blokować uruchomienia, ale decyzja o akceptacji ryzyka powinna być jawna, uzasadniona i zatwierdzona przez właściwe role. Przed uruchomieniem należy potwierdzić gotowość procedur, wsparcia, szkoleń, zarządzania dostępem, kopii zapasowych, monitorowania i obsługi incydentów. Walidacja techniczna bez gotowości operacyjnej nie zapewnia kontroli nad systemem. 6. Dokumentacja walidacyjna systemu SaaS Pakiet dokumentacji powinien umożliwiać prześledzenie drogi od zamierzonego zastosowania i wymagań do ryzyk, kontroli, testów i decyzji o dopuszczeniu. Nazwy dokumentów mogą różnić się między organizacjami. Ważniejsze od liczby szablonów jest to, czy dowody są kompletne, zatwierdzone, aktualne i możliwe do odtworzenia podczas inspekcji. Dokument lub zapis Główne zastosowanie Elementy wymagające uwagi w SaaS Ocena wpływu GxP Ustalenie, czy i w jakim zakresie system podlega kontroli Analiza na poziomie funkcji i przepływów danych Plan walidacji Zakres, role, metody, środowiska i kryteria akceptacji Wskazanie dowodów dostawcy oraz działań klienta Ocena dostawcy Uzasadnienie zaufania do procesów i usługi Podwykonawcy, hosting, SDLC, aktualizacje, audyty URS Zatwierdzone wymagania użytkownika i wymagania regulacyjne Kryteria testowalne dla danych, audytu, podpisów i eksportu Ocena ryzyka Powiązanie funkcji z ryzykiem i kontrolami Krytyczność konfiguracji, integracji i automatycznych zmian Specyfikacja konfiguracji Kontrolowany opis ustawień systemu Workflow, role, reguły, rozszerzenia i ustawienia retencji Protokoły i dowody testowe Potwierdzenie spełnienia wymagań Wersja, środowisko, dane testowe, wyniki i odchylenia Macierz śledzenia Powiązanie wymagań, ryzyk i testów Wskazanie, które dowody pochodzą od dostawcy Raport walidacyjny Podsumowanie i decyzja o dopuszczeniu Ryzyka rezydualne, warunki uruchomienia i plan działań Plan utrzymania Zasady kontroli po uruchomieniu Ocena wydań, testy regresji, przeglądy i wycofanie Dokumentacja dostawcy powinna być przyjmowana świadomie. Raport z testów producenta ma wartość tylko wtedy, gdy wiadomo, której wersji dotyczy, jaki był zakres testu, jakie kryteria zastosowano i czy wynik odnosi się do funkcji wykorzystywanych przez klienta. 7. Integralność danych i zasady ALCOA System SaaS powinien wspierać zachowanie danych, które można przypisać do osoby, odczytać, powiązać z czasem wykonania, zachować w formie oryginalnej lub zweryfikowanej kopii oraz uznać za dokładne. Rozszerzone zasady ALCOA+ obejmują także kompletność, spójność, trwałość i dostępność danych. Ocena integralności danych powinna objąć: unikalne konta i odpowiedzialność za działania użytkownika; synchronizację czasu i znaczenie stref czasowych; ochronę oryginalnych danych oraz powiązanych metadanych; kontrolę zmian i możliwość przeglądu ścieżki audytowej; kompletność eksportów, raportów i zweryfikowanych kopii; zabezpieczenie danych podczas integracji i migracji; retencję, archiwizację, wyszukiwanie i odczyt przez wymagany okres; możliwość odzyskania danych po awarii oraz potwierdzenie skuteczności odtworzenia. Nie wystarczy sprawdzić, czy funkcja audit trail istnieje. Organizacja powinna ustalić, czy jest zawsze aktywna dla krytycznych zdarzeń, kto może zmienić jej ustawienia, jak prezentuje zmiany i jak będzie regularnie przeglądana. Jeżeli dostawca ma uprzywilejowany dostęp administracyjny, jego działania również powinny podlegać odpowiednim mechanizmom nadzoru. 8. Aktualizacje i utrzymanie stanu zwalidowanego Największym wyzwaniem w SaaS bywa nie pierwsza walidacja, lecz rytm późniejszych zmian. Dostawca może publikować wiele wydań w roku, a część funkcji może być aktywowana automatycznie. Organizacja potrzebuje procesu, który szybko odróżnia zmianę nieistotną od zmiany wpływającej na proces GxP. Proces obsługi wydania powinien obejmować: Pozyskanie release notes i informacji o planowanym terminie. Identyfikację zmienionych funkcji, interfejsów, danych i wymagań. Ocenę wpływu na konfigurację, ryzyka oraz dokumentację. Decyzję o zakresie testów regresji i potrzebnych działaniach. Wykonanie oraz zatwierdzenie testów przed użyciem zmiany w procesie GxP, jeżeli jest to możliwe. Aktualizację dokumentacji, materiałów szkoleniowych i macierzy śledzenia. Udokumentowane dopuszczenie wydania lub zastosowanie uzgodnionego działania ograniczającego ryzyko. Umowa z dostawcą powinna zapewniać wystarczający czas na ocenę zmian, dostęp do środowiska testowego i czytelne informacje o wpływie wydania. Jeżeli klient nie może odroczyć aktualizacji, proces musi uwzględniać krótkie okno oceny, priorytetowe scenariusze regresji oraz plan reakcji na nieakceptowalny wynik. Stan zwalidowany utrzymują także codzienne procesy operacyjne: przeglądy dostępów, zarządzanie incydentami, CAPA, monitorowanie interfejsów, okresowa ocena, szkolenia, przegląd audit trail, testowanie odtworzenia i kontrolowane wycofanie systemu. 9. Najczęstsze błędy w walidacji SaaS 9.1 Poleganie wyłącznie na certyfikatach dostawcy ISO 27001 lub raport SOC może wspierać kwalifikację bezpieczeństwa i kontroli organizacyjnych. Nie potwierdza jednak, że konkretna konfiguracja, workflow, raport i rola użytkownika spełniają wymagania procesu GxP. 9.2 Kopiowanie klasycznego modelu CSV bez uwzględnienia SaaS Powielanie dokumentów i testów przeznaczonych dla systemu instalowanego lokalnie może tworzyć duży nakład pracy bez pokrycia najważniejszych ryzyk SaaS. Strategia powinna wykorzystywać dowody dostawcy i koncentrować działania klienta na konfiguracji, danych, integracjach oraz sposobie użycia. 9.3 Brak jasnego podziału odpowiedzialności Nieprecyzyjna umowa utrudnia dostęp do dowodów, analizę incydentów i ocenę aktualizacji. Podział obowiązków powinien obejmować również podwykonawców, wsparcie administracyjne, kopie danych i zakończenie usługi. 9.4 Testowanie tylko scenariusza prawidłowego Proces może działać poprawnie przy typowych danych, a zawodzić przy błędzie integracji, duplikacie, cofnięciu zatwierdzenia albo utracie połączenia. Testy negatywne i obsługa wyjątków są szczególnie ważne dla krytycznych przepływów. 9.5 Jednorazowa walidacja bez procesu zmian Dokumentacja szybko traci aktualność, jeżeli organizacja nie ocenia kolejnych wydań. W SaaS plan utrzymania stanu zwalidowanego powinien powstać przed uruchomieniem, a nie dopiero przy pierwszej dużej aktualizacji. 9.6 Mylenie dostępności z możliwością odtworzenia procesu Wysoki poziom dostępności usługi nie gwarantuje, że firma odzyska kompletne dane i wznowi regulowany proces w wymaganym czasie. Trzeba odrębnie ocenić kopie, retencję, parametry odtworzenia, eksport danych oraz procedurę pracy awaryjnej. 10. Checklista walidacji systemu SaaS zgodnego z GxP [ ] Zdefiniowaliśmy zamierzone zastosowanie, granice systemu i właściciela procesu. [ ] Oceniliśmy wpływ poszczególnych funkcji na pacjenta, produkt i integralność danych. [ ] Zidentyfikowaliśmy przepisy GxP i rodzaje zapisów elektronicznych mające zastosowanie. [ ] Udokumentowaliśmy przepływy danych, metadanych, integracji, eksportów i archiwów. [ ] Przeprowadziliśmy kwalifikację dostawcy oraz ocenę jego systemu jakości i SDLC. [ ] Zweryfikowaliśmy dostawców infrastruktury, podwykonawców i lokalizacje przetwarzania danych. [ ] Ustaliliśmy podział odpowiedzialności w umowie i uzgodnieniu jakościowym. [ ] Przygotowaliśmy testowalne wymagania użytkownika oraz kryteria akceptacji. [ ] Przeprowadziliśmy udokumentowaną ocenę ryzyka funkcji, danych i interfejsów. [ ] Zatwierdziliśmy konfigurację, role, workflow, reguły retencji i rozszerzenia. [ ] Zweryfikowaliśmy migrację danych oraz kompletność interfejsów. [ ] Przetestowaliśmy krytyczne procesy, wyjątki, uprawnienia, audit trail i podpisy. [ ] Powiązaliśmy wymagania i ryzyka z dowodami w macierzy śledzenia. [ ] Zamknęliśmy odchylenia albo formalnie zaakceptowaliśmy ryzyko rezydualne. [ ] Zatwierdziliśmy raport walidacyjny i gotowość operacyjną przed uruchomieniem. [ ] Mamy proces oceny release notes, zmian i testów regresji. [ ] Prowadzimy okresowe przeglądy dostawcy, systemu, dostępów i stanu walidacji. [ ] Przetestowaliśmy kopie zapasowe, odtworzenie, ciągłość działania i eksport danych. [ ] Określiliśmy zasady archiwizacji, retencji i kontrolowanego zakończenia usługi. [ ] Personel został przeszkolony odpowiednio do roli i odpowiedzialności. 11. Jak wybrać partnera do walidacji systemu SaaS Partner powinien rozumieć zarówno wymagania jakościowe, jak i techniczną architekturę rozwiązania. Sama znajomość szablonów CSV nie wystarczy do oceny integracji, modelu tożsamości, mechanizmów chmurowych, automatycznych wydań i dowodów dostawcy. Przed rozpoczęciem współpracy warto sprawdzić, czy partner potrafi: przełożyć zamierzone zastosowanie na zakres GxP i strategię opartą na ryzyku; ocenić dostawcę SaaS, dokumentację produktu i podział odpowiedzialności; przygotować URS, analizę ryzyka, plan, testy, macierz śledzenia i raport; połączyć wymagania jakościowe z bezpieczeństwem, architekturą i integracją danych; zaprojektować proces utrzymania stanu zwalidowanego po częstych aktualizacjach; wspierać zespół QA, IT i właścicieli biznesowych bez przejmowania ich decyzji regulacyjnych. Zakres usług powinien być dostosowany do dojrzałości organizacji. Jedna firma potrzebuje niezależnego przeglądu strategii, inna pełnego prowadzenia dokumentacji i testów, a jeszcze inna stałego wsparcia przy kolejnych wydaniach SaaS. 12. Dlaczego TTMS Walidacja systemów SaaS w farmacji wymaga współpracy QA, właścicieli procesów, IT, bezpieczeństwa i zespołów wdrożeniowych. TTMS łączy kompetencje w zakresie walidacji systemów skomputeryzowanych z doświadczeniem w rozwoju, integracji, testowaniu i utrzymaniu oprogramowania dla branż regulowanych. Zakres współpracy może obejmować ocenę wpływu GxP, kwalifikację dostawcy, opracowanie strategii i dokumentacji walidacyjnej, przegląd architektury oraz konfiguracji, przygotowanie testów, wsparcie migracji danych i utrzymanie stanu zwalidowanego. Model pracy można dopasować do nowego wdrożenia, systemu już używanego operacyjnie albo programu obejmującego wiele aplikacji chmurowych. Praktyczne wsparcie TTMS może obejmować: Inwentaryzację systemów, funkcji i przepływów danych objętych GxP. Ocenę luk w dokumentacji, kontroli i podziale odpowiedzialności. Przygotowanie roadmapy działań według ryzyka i krytyczności procesów. Opracowanie oraz wykonanie uzgodnionych działań walidacyjnych. Wsparcie przy aktualizacjach, testach regresji i okresowych przeglądach. Celem współpracy jest zbudowanie dowodów, które odpowiadają rzeczywistemu sposobowi użycia systemu i mogą być utrzymywane po jego uruchomieniu. Ostateczne decyzje dotyczące zakresu GxP, akceptacji ryzyka i dopuszczenia systemu pozostają częścią systemu jakości klienta. 13. Rozmowa o walidacji SaaS Jeżeli Twoja organizacja planuje wdrożenie systemu chmurowego albo chce uporządkować walidację już używanej aplikacji, warto rozpocząć od oceny zamierzonego zastosowania, dostawcy i cyklu wydawniczego. Pozwala to określić zakres prac przed przygotowaniem dokumentacji i testów. Skontaktuj się z TTMS, aby omówić strategię walidacji, ocenę dostawcy SaaS lub utrzymanie stanu zwalidowanego w środowisku GxP. FAQ Czy każdy system SaaS używany w firmie farmaceutycznej wymaga walidacji? Nie. Zakres zależy od zamierzonego zastosowania oraz wpływu systemu na działalność GxP. Aplikacja używana wyłącznie do zadań administracyjnych może pozostawać poza zakresem, natomiast system tworzący lub przetwarzający krytyczne zapisy GxP wymaga udokumentowanej oceny i odpowiednich kontroli. Czy system może być certyfikowany jako zgodny z GxP? Nie istnieje jeden uniwersalny certyfikat, który zwalnia klienta z oceny zamierzonego zastosowania i walidacji. Dostawca może oferować funkcje i dokumentację wspierające zgodność, ale status systemu zależy od jego konfiguracji, procesu, danych, procedur i kontroli organizacji. Czy certyfikat ISO 27001 dostawcy wystarczy do walidacji? Nie. Certyfikat może wspierać ocenę systemu zarządzania bezpieczeństwem, ale nie potwierdza konfiguracji klienta, krytycznych workflow, integralności konkretnych zapisów ani skuteczności kontroli GxP. Jest jednym z dowodów wykorzystywanych w kwalifikacji dostawcy. Jak zwalidować automatyczne aktualizacje SaaS? Organizacja potrzebuje procesu pozyskiwania informacji o wydaniu, oceny wpływu, kwalifikacji zmiany i testów regresji. Krytyczne scenariusze powinny być możliwe do wykonania w środowisku testowym przed zastosowaniem wersji w procesie GxP albo w uzgodnionym, kontrolowanym oknie po wdrożeniu. Czy 21 CFR Part 11 ma zastosowanie do każdego systemu SaaS? Nie. Zastosowanie Part 11 zależy od tego, czy system utrzymuje lub przekazuje zapisy elektroniczne wymagane przez przepisy FDA i czy wykorzystywane są podpisy elektroniczne objęte zakresem regulacji. Analizę należy prowadzić razem z odpowiednimi przepisami bazowymi.
Czytaj
RAG dla chatbota na przykładzie CrewAI – notatki z TTMS Tech Talk
Tech Talk to wewnętrzny cykl spotkań technologicznych dla pracowników TTMS, podczas których dzielimy się wiedzą i doświadczeniami z projektów. Pokazujemy sprawdzone narzędzia, omawiamy napotkane problemy i rozwiązania, które pomogły nam w pracy. Tematy obejmują m.in. sztuczną inteligencję, analitykę danych, Salesforce, AEM i zarządzanie projektami. Po prezentacjach jest czas na pytania, dyskusję i wymianę pomysłów. Podczas spotkania „RAG dla chatbota na przykładzie CrewAI”, które odbyło się 17 września, Jakub Kraśniewski, Senior AI Developer w TTMS, opowiedział o usprawnieniu chatbota korzystającego z dokumentacji klienta. Przedstawił problemy z przygotowaniem i wyszukiwaniem informacji, zastosowane rozwiązanie oraz sposób sprawdzania jakości odpowiedzi. Projekt dotyczył firmy z sektora edukacyjnego, której klienci przygotowują się do egzaminu certyfikacyjnego. Chatbot miał pomagać im w uzyskiwaniu informacji o zapisach, przebiegu egzaminu, ocenianiu i odwołaniach, a tym samym odciążyć dział wsparcia. Korzystał z publicznie dostępnych dokumentów PDF obejmujących kilkaset stron, głównie w języku angielskim. Zespół potrzebował sposobu na trafne wyszukiwanie odpowiedzi w tych materiałach przy wymaganym czasie oczekiwania rzędu 4 do 5 sekund. 1. Jak RAG pomaga chatbotowi korzystać z wiedzy firmy? Na początku prezentacji Jakub wyjaśnił, jak działa RAG (Retrieval-Augmented Generation), czyli generowanie odpowiedzi z wykorzystaniem wyszukanych materiałów źródłowych. System odnajduje informacje związane z pytaniem użytkownika i przekazuje je modelowi językowemu jako kontekst odpowiedzi. W omawianym projekcie były to fragmenty dokumentacji opisującej zasady i procedury egzaminacyjne. Po odczytaniu tekstu z dokumentów system dzieli go na mniejsze fragmenty. Model embeddingowy (model AI przedstawiający cechy znaczeniowe tekstu w postaci liczb) przekształca je w wektory zapisywane w bazie. W ten sam sposób przetwarzane jest pytanie użytkownika. Porównanie tych reprezentacji pozwala wyszukać fragmenty powiązane znaczeniowo z pytaniem. Jakub podkreślał, że zespół odpowiada za jakość materiałów przekazywanych modelowi. Trzeba sprawdzić, czy tekst został poprawnie odczytany, czy podział zachował potrzebny kontekst i czy wyszukiwanie dostarcza informacje przydatne do odpowiedzi. Znaczenie tych etapów pokazały problemy, na które zespół natrafił w rozwiązaniu wykorzystującym CrewAI. 2. Co utrudniało wyszukiwanie informacji w projekcie z CrewAI? Po wyjaśnieniu podstaw RAG Jakub przeszedł do doświadczeń z projektu wykorzystującego CrewAI, zestaw narzędzi do budowania systemów opartych na agentach AI. Omówił trzy problemy napotkane w używanej konfiguracji: zbyt obszerne fragmenty tekstu, brak dodatkowej oceny trafności wyników oraz błędy w odczycie dokumentów PDF. 2.1 Zbyt obszerne fragmenty dokumentów W konfiguracji opisanej przez Jakuba tekst dzielono na fragmenty po 4000 znaków. Dla jednego pytania system pobierał pięć takich fragmentów, więc do modelu trafiało nawet około 20 000 znaków materiału źródłowego. Duży fragment może zawierać informacje dotyczące kilku różnych zagadnień, co utrudnia dopasowanie go do konkretnego pytania. Model generujący odpowiedź musi następnie wybrać potrzebne informacje spośród przekazanych treści. W tym projekcie sposób podziału dokumentów wymagał więc dostosowania do ich struktury i pytań użytkowników. 2.2 Brak dodatkowej oceny trafności wyników Jakub zwrócił uwagę, że w używanej konfiguracji brakowało rerankingu, czyli ponownej oceny i uporządkowania wyników wyszukiwania według ich przydatności do odpowiedzi na pytanie użytkownika. System może najpierw wyszukać większą liczbę fragmentów, a następnie poddać je dodatkowej ocenie, aby wybrać te najbardziej przydatne do przygotowania odpowiedzi. Jakub wskazał tę metodę jako możliwe usprawnienie, którego przydatność warto ocenić, sprawdzając zarówno jakość odpowiedzi, jak i czas oczekiwania na nią. 2.3 Błędna kolejność odczytu tekstu w wielokolumnowych PDF-ach Kolejny problem dotyczył odczytu dokumentów. Narzędzie pobierało tekst z wielokolumnowych PDF-ów wiersz po wierszu, łącząc treści z sąsiadujących kolumn. Zaburzało to kolejność zdań i utrudniało późniejsze wyszukiwanie informacji. Tak przetworzony tekst trafiał do dalszego podziału na fragmenty. Błąd powstawał więc już podczas przygotowania danych i wpływał na kolejne etapy pracy z dokumentacją. Ten przykład pokazał, dlaczego sprawdzanie jakości RAG warto rozpocząć od porównania odczytanego tekstu z dokumentem źródłowym. 3. Jak czas odpowiedzi wpływa na wybór między Classic RAG, Agentic RAG i Graph RAG? W projekcie istotnym wymaganiem była odpowiedź w czasie około 4 do 5 sekund. Jakub omówił trzy podejścia do RAG z perspektywy kosztu przygotowania danych, możliwości sprawdzania działania oraz czasu potrzebnego na obsługę pytania. Podejście Sposób działania omawiany na spotkaniu Co uwzględnić przy wyborze Classic RAG Wyszukiwanie fragmentów w bazie wiedzy, opcjonalny reranking i przekazanie kontekstu do modelu. Jakość podziału dokumentów, trafność wyszukiwania i objętość przekazywanego kontekstu. Agentic RAG Agent dobiera narzędzia i sposób wyszukiwania, a w razie potrzeby wykonuje kolejne zapytania. Możliwość dostosowania wyszukiwania do pytania oraz czas i koszt dodatkowych operacji. Graph RAG Wyszukiwanie wykorzystuje graf wiedzy opisujący obiekty występujące w materiałach oraz relacje między nimi. Nakład na budowę i utrzymanie grafu oraz przydatność relacji dla pytań użytkowników. W podejściu agentowym model może korzystać z kilku narzędzi, na przykład wyszukiwania wektorowego, wyszukiwania po słowach kluczowych lub filtrowania po metadanych opisujących dokument. Kolejne kroki pozwalają rozbudowywać poszukiwanie informacji, a ich liczba i kolejność wpływają na czas odpowiedzi. W przedstawionym podejściu grafowym część pracy wykonywana jest podczas budowania bazy wiedzy. Z tekstu wydobywa się obiekty i łączące je relacje. Taki mechanizm stanowi również podstawę GraphRAG opisanego przez Microsoft. Jakub zwracał uwagę na koszty tego przygotowania i trudność ręcznej analizy rozbudowanego grafu. W omawianym projekcie wymagany czas odpowiedzi przemawiał za rozwijaniem klasycznego RAG. Zespół skupił się na sposobie podziału dokumentów i doboru kontekstu. 4. Jak hierarchiczne dzielenie dokumentów pomaga zachować kontekst? Zastosowane rozwiązanie polegało na uporządkowaniu materiału na trzech powiązanych poziomach: strony, akapitu i zdania. System zachowywał informację o tym, do którego akapitu należy zdanie oraz na której stronie znajduje się akapit. Treść była reprezentowana w bazie wektorowej na różnych poziomach szczegółowości. Dzięki temu wyszukiwanie mogło odnaleźć zarówno konkretne zdanie, jak i większy fragment zawierający potrzebne informacje. Według relacji Jakuba dodatkowy koszt przechowywania i przetwarzania tych reprezentacji był akceptowalny przy skali materiałów w projekcie. Odnalezienie trafnego zdania pozwalało pobrać obejmujący je akapit i przekazać modelowi szerszy kontekst. W zależności od potrzeb można było sięgnąć również po całą stronę. Załóżmy, że użytkownik pyta o termin odwołania od wyniku egzaminu. System odnajduje zdanie określające ten termin, a następnie pobiera cały akapit, który wyjaśnia, od kiedy należy go liczyć i jak złożyć odwołanie. Dzięki temu model może uwzględnić te warunki w odpowiedzi. 5. Jak sprawdzać jakość RAG na własnych danych? W końcowej części prezentacji Jakub podkreślił znaczenie benchmarku, czyli zestawu testów pozwalającego porównywać warianty rozwiązania. Omówił sprawdzanie wyników wyszukiwania względem informacji oznaczonych przez człowieka oraz wykorzystanie modelu językowego do oceny odpowiedzi. W praktyce warto rozdzielić ocenę na dwa poziomy. Pierwszy dotyczy wyszukiwania: czy system dostarczył fragment zawierający potrzebną informację? Drugi obejmuje odpowiedź: czy model poprawnie wykorzystał otrzymany materiał? Taki podział pomaga ustalić, który etap wymaga poprawy. W dodatkowych informacjach przekazanych po spotkaniu Jakub doprecyzował sposób testowania i uzyskane wyniki. Zestaw testowy obejmował pytania z całego zakresu dokumentacji oraz rzeczywiste pytania użytkowników, zebrane anonimowo podczas uruchomienia prototypu na początku roku. Dokładność odpowiedzi wzrosła z około 70% do około 98%, czyli o około 28 punktów procentowych. Wynik dotyczy wewnętrznego testu przeprowadzonego w tym projekcie. Według relacji Jakuba rozwiązanie zachowało również szybki czas odpowiedzi. W chwili przekazania tych informacji chatbot miał za sobą testy wewnętrzne, a firma planowała udostępnić go części klientów. Odciążenie działu wsparcia i ułatwienie dostępu do informacji pozostawały celami wdrożenia. Ocena ich realizacji wymaga danych z użytkowania narzędzia. Osobnym obszarem oceny pozostaje model embeddingowy. Jakub wskazywał, że jego dobór powinien uwzględniać język materiałów i wyniki uzyskiwane na własnym zbiorze danych. Wybór tego modelu wpływa na to, jakie fragmenty system odnajdzie, zanim rozpocznie generowanie odpowiedzi. 6. Co z tych doświadczeń wynika dla firm wdrażających chatbota? Omówiony projekt pokazuje, jak konkretne wymagania porządkują pracę nad RAG. Oczekiwany czas odpowiedzi pomógł zawęzić wybór rozwiązania, analiza dokumentów ujawniła problemy z odczytem i podziałem treści, a wewnętrzny test pozwolił ocenić efekt zmian. Przy planowaniu podobnego wdrożenia warto uporządkować pięć kwestii: Materiały źródłowe: sprawdzić, czy odczyt dokumentów zachowuje sens i kolejność tekstu. Podział treści: dopasować wielkość fragmentów i powiązania między nimi do struktury materiałów. Pytania użytkowników: przygotować zestaw odzwierciedlający zadania, które chatbot ma obsługiwać. Czas odpowiedzi: ustalić oczekiwania i uwzględniać je podczas porównywania wariantów. Ocena jakości: sprawdzać zarówno trafność wyszukanych informacji, jak i sposób wykorzystania ich w odpowiedzi. Porozmawiajmy o AI w Twojej firmie W TTMS pracują eksperci, którzy tak jak Jakub łączą wiedzę technologiczną z doświadczeniem w projektach dla klientów. Podczas Tech Talków dzielą się rozwiązaniami sprawdzonymi w praktyce, a zdobytą wiedzę wykorzystują w kolejnych wdrożeniach. Planujesz chatbota korzystającego z firmowej dokumentacji lub chcesz poprawić jakość odpowiedzi istniejącego narzędzia? Zapraszamy do rozmowy. Przyjrzymy się Twoim materiałom, potrzebom użytkowników i celom biznesowym, aby zaproponować odpowiedni sposób wykorzystania AI. Skontaktuj się z zespołem TTMS! Jakie dokumenty mogą tworzyć bazę wiedzy chatbota z RAG? Chatbot z RAG może korzystać z firmowych polityk, instrukcji obsługi produktów, procedur, odpowiedzi na najczęściej zadawane pytania i innych materiałów zawierających informacje przydatne użytkownikom. W zależności od dostępnych integracji źródłami mogą być pliki PDF, dokumenty Word, treści stron internetowych i artykuły z bazy wiedzy. Zeskanowane dokumenty wymagają optycznego rozpoznawania znaków (OCR), które przekształca obraz tekstu w treść możliwą do przeszukiwania. Tabele, diagramy i złożone układy stron mogą wymagać dodatkowego przetwarzania, aby zachować ich znaczenie. Przed dodaniem dokumentów należy sprawdzić, czy są poprawne, aktualne i zatwierdzone do udostępnienia danej grupie odbiorców. Przejrzysta struktura materiałów pomaga systemowi wyszukiwać informacje i dostarczać kontekst potrzebny do odpowiedzi. Jak aktualizować bazę wiedzy chatbota z RAG? Utrzymanie aktualnej bazy wiedzy chatbota z RAG wymaga procesu wykrywania i przetwarzania zmian w materiałach źródłowych. W zależności od potrzeb firmy aktualizacje mogą odbywać się według harmonogramu lub po dodaniu, zmianie albo usunięciu dokumentu. System aktualizuje wówczas przeszukiwane treści oraz powiązane z nimi reprezentacje, takie jak embeddingi, czyli liczbowe reprezentacje cech znaczeniowych tekstu. Informacje o wersji i datach obowiązywania pomagają odróżnić aktualne wytyczne od starszych materiałów. Dokumenty usunięte lub zastąpione nowszymi wersjami należy również wycofać z aktywnych wyników wyszukiwania, a odpowiedzi zapisane w pamięci podręcznej mogą wymagać odświeżenia. Wyznaczenie osoby odpowiedzialnej za każdy obszar treści pomaga zadbać o jakość informacji wykorzystywanych przez chatbota. Czy chatbot z RAG może podawać źródła swoich odpowiedzi? Tak, chatbot z RAG może dołączać do odpowiedzi linki, tytuły dokumentów, numery stron lub cytowane fragmenty. Wymaga to zachowania informacji o źródłach podczas przetwarzania dokumentów i powiązania wyszukanych fragmentów z odpowiedzią. Przydatne odwołania pozwalają użytkownikowi otworzyć właściwy materiał i samodzielnie sprawdzić kontekst. System powinien również weryfikować, czy każde wskazane źródło potwierdza informację, do której się odnosi. Sam link do źródła nie gwarantuje, że odpowiedź poprawnie odzwierciedla treść dokumentu. Podczas testów należy sprawdzać zarówno jakość odpowiedzi, jak i poprawność odwołań, w tym możliwość otwarcia wskazanych materiałów przez użytkownika. Jak chatbot z RAG może uwzględniać uprawnienia dostępu do dokumentów firmowych? Chatbot z RAG może wykorzystywać tożsamość i uprawnienia zalogowanego użytkownika, aby określić, które dokumenty wolno mu przeszukiwać. Weryfikacja uprawnień powinna nastąpić, zanim treści objęte ograniczeniami dostępu trafią do modelu językowego. Te same zasady muszą obejmować podgląd dokumentów, odwołania do źródeł i odpowiedzi zapisane w pamięci podręcznej, jeśli zawierają chronione informacje. Zmiany uprawnień w systemie źródłowym powinny być również uwzględniane podczas wyszukiwania informacji przez chatbota. Zespół powinien przetestować rozwiązanie na kontach o różnych rolach, w tym z ograniczonym dostępem. Takie testy pomagają potwierdzić, że każda osoba otrzymuje odpowiedzi oparte na informacjach, do których ma uprawnienia. Co powinien zrobić chatbot z RAG, gdy nie znajdzie odpowiedzi? Gdy dostępne dokumenty zawierają zbyt mało informacji, chatbot z RAG powinien jasno poinformować, że na podstawie swoich źródeł nie może udzielić wiarygodnej odpowiedzi. Jeśli pytanie jest niejednoznaczne, może poprosić o doprecyzowanie lub wskazać powiązany dokument, który może pomóc użytkownikowi. W sprawach wymagających dalszej pomocy może skierować go do odpowiedniego zespołu lub kanału wsparcia. System potrzebuje jasno określonych zasad postępowania z informacjami niepełnymi, sprzecznymi lub brakującymi. Testy powinny obejmować pytania, na które baza wiedzy nie zawiera odpowiedzi, aby zespół mógł ocenić zachowanie chatbota w takich sytuacjach. Analiza pytań pozostawionych bez odpowiedzi może również ujawnić luki w dokumentacji firmy i pomóc ustalić priorytety kolejnych aktualizacji.
Czytaj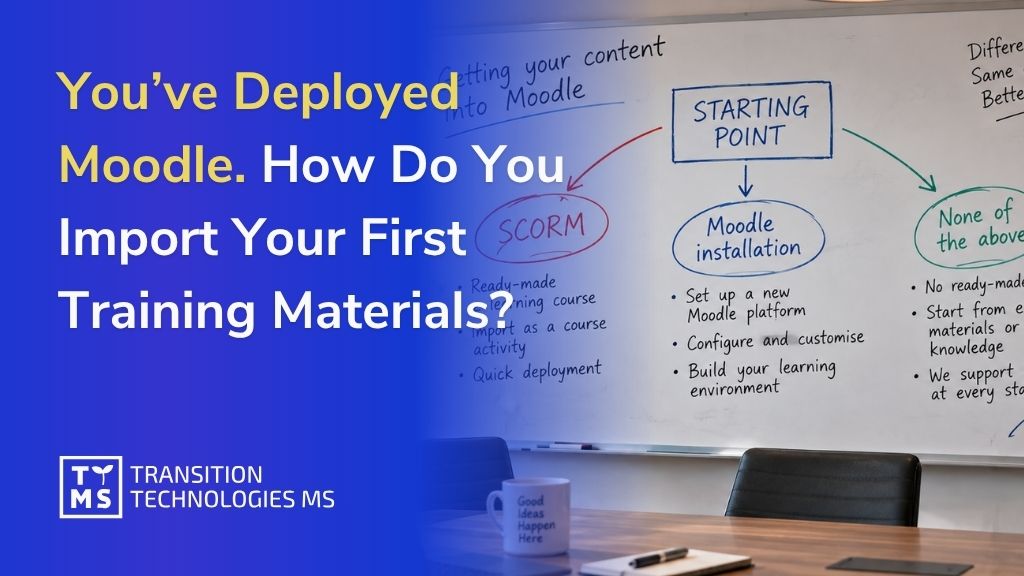
Wdrożyłeś Moodle. Jak zaimportować pierwsze materiały szkoleniowe?
Zainstalowana i skonfigurowana platforma Moodle to dopiero połowa drogi do uruchomienia szkoleń w firmie. Kolejnym krokiem jest przeniesienie do niej realnej zawartości: kursów z poprzedniego systemu, gotowych pakietów SCORM albo listy pracowników, którzy mają z platformy korzystać. W tym artykule pokazujemy, jak wygląda ten proces krok po kroku – i co zrobić, jeśli materiałów szkoleniowych jeszcze w ogóle nie macie. 1. Zanim zaczniesz: sprawdź jaki jest Twój punkt wyjścia importu do Moodle Sposób importu zależy od tego, co dokładnie chcesz przenieść do Moodle. W praktyce firmy trafiają w jedną z trzech sytuacji: Macie już gotowy kurs w formacie SCORM – wyprodukowany wcześniej, kupiony u zewnętrznego dostawcy albo wyeksportowany z innego systemu LMS. W takim wypadku wystarczy go zaimportować jako aktywność w kursie. Macie pełną kopię zapasową kursu z innej instancji Moodle (plik .mbz) – np. z environmentu testowego, z poprzedniego wdrożenia albo od firmy, która wcześniej obsługiwała waszą platformę. Wtedy importujecie cały kurs razem ze strukturą. Nie macie jeszcze żadnego z powyższych – macie za to prezentacje, procedury PDF, nagrania onboardingowe albo po prostu wiedzę w głowach pracowników, którą trzeba dopiero zamienić w kurs. To najczęstsza sytuacja zaraz po wdrożeniu i wymaga innego podejścia, o którym piszemy w ostatniej sekcji. Poniższe instrukcje dotyczą dwóch pierwszych przypadków. Nazwy opcji i ich umiejscowienie mogą się nieznacznie różnić w zależności od wersji Moodle, jednak główne etapy procesu pozostają podobne. Dla pewności warto również zapoznać się z aktualną oficjalną dokumentacją Moodle. Linki do odpowiednich materiałów znajdziesz w dalszej części artykułu. 2. Import całego kursu z pliku kopii zapasowej (.mbz) Jeśli dysponujecie plikiem .mbz – czyli pełnym backupem kursu wraz ze strukturą sekcji, aktywnościami i (opcjonalnie) plikami – proces wygląda następująco: Zaloguj się do Moodle z uprawnieniami nauczyciela lub managera i wejdź do kursu, do którego chcesz wgrać zawartość (może to być nowo utworzony, pusty kurs). Z menu kursu wybierz Więcej → Wykorzystanie kursu (Course reuse) → Przywróć (Restore). Wskaż plik .mbz – możesz go wgrać z dysku lub wskazać plik już umieszczony w obszarze plików kursu. Moodle przeprowadzi Cię przez kilka ekranów: potwierdzenie pliku, ustawienia przywracania (czy scalić zawartość z istniejącym kursem, czy nadpisać go w całości) oraz wybór, które elementy mają zostać przywrócone. Na etapie przeglądu zobaczysz pełną listę tego, co zostanie zaimportowane. To ostatni moment, żeby cofnąć się i coś poprawić. Po zatwierdzeniu proces przywracania działa w tle – w zależności od wielkości kursu może to potrwać od kilkudziesięciu sekund do kilku minut. Ważna uwaga: pełny backup zwykle nie zawiera danych użytkowników takich jak wyniki quizów czy wpisy na forum, o ile świadomie nie zaznaczono tej opcji przy tworzeniu kopii. To zabezpieczenie, które chroni przed przypadkowym przeniesieniem danych osobowych między środowiskami. Więcej informacji o tworzeniu kopii zapasowych i przywracaniu kursów znajdziesz w oficjalnej dokumentacji Moodle. Szczegółowy opis procesu jest dostępny w materiałach. 3. Import pojedynczych elementów z innego kursu Jeśli nie potrzebujecie całego kursu, a tylko wybranych materiałów – np. jednego modułu, quizu albo zestawu plików – Moodle oferuje osobną funkcję Import, dostępną w tym samym miejscu co Przywracanie: Wejdź do kursu docelowego i wybierz Więcej → Wykorzystanie kursu → Import. Wyszukaj kurs źródłowy (musisz mieć w nim uprawnienia edycyjne). Zaznacz, które typy elementów chcesz przenieść: aktywności, bloki, filtry. Na kolejnym ekranie zaznacz konkretne pozycje – możesz wybrać pojedynczy quiz czy plik, zamiast całej sekcji. Zatwierdź import i poczekaj na komunikat o zakończeniu operacji. Ta metoda jest wygodna, gdy budujecie kilka podobnych kursów (np. dla różnych działów) i chcecie ponownie wykorzystać część wspólnych materiałów, zamiast tworzyć je od nowa za każdym razem. 4. Import pakietu SCORM jako aktywności kursu Pakiet SCORM to najpopularniejszy format gotowego kursu e-learningowego – niezależnie od tego, czy powstał u zewnętrznego dostawcy, w narzędziu autorskim, czy w wyniku eksportu z innego systemu. Import wygląda inaczej niż w przypadku backupu kursu, bo SCORM jest tu jedną aktywnością wewnątrz kursu, a nie całym kursem: Wejdź do kursu, w którym ma się pojawić szkolenie, i włącz tryb edycji. W wybranej sekcji kliknij Dodaj aktywność lub zasób i z listy wybierz Pakiet SCORM. Wgraj plik .zip zawierający pakiet SCORM. Skonfiguruj podstawowe ustawienia: sposób oceniania (np. na podstawie najwyższego wyniku czy ostatniej próby), liczbę dozwolonych podejść oraz sposób wyświetlania treści (w nowym oknie czy w ramach strony kursu). Zapisz i wróć do kursu – zobaczysz nową aktywność, gotową do otwarcia przez użytkowników. Warto przetestować pakiet z poziomu konta testowego przed udostępnieniem go docelowej grupie – zwłaszcza jeśli pakiet SCORM pochodzi z zewnętrznego źródła i nie macie pewności co do jego zgodności z wersją Moodle. 5. Import listy użytkowników i przypisanie ról Materiały to jedna strona równania – druga to ludzie, którzy mają z nich korzystać. Zamiast dodawać każdego pracownika ręcznie, można zaimportować listę zbiorczo: Przygotuj plik CSV z kolumnami takimi jak imię, nazwisko, adres e-mail i nazwa użytkownika (dokładny wymagany format zależy od konfiguracji platformy). Przejdź do Administracja witryny → Użytkownicy → Prześlij użytkowników. Wgraj plik CSV i przejrzyj podgląd – Moodle pokaże, jak zinterpretuje poszczególne kolumny i czy nie ma błędów w danych. Zatwierdź import. Nowe konta zostaną utworzone automatycznie, a jeśli plik zawierał odpowiednie kolumny, użytkownicy mogą zostać od razu zapisani na wskazane kursy. Osobno przypisz role (np. nauczyciel, uczestnik, menedżer) w kursach lub na poziomie kategorii, jeśli nie zrobił tego import. Jeśli firma korzysta z logowania SSO (np. przez Azure AD lub Microsoft 365), część tego procesu może być zautomatyzowana przez synchronizację kont – to jednak osobny temat, wykraczający poza ręczny import. Więcej informacji o opisanych funkcjach znajdziesz w oficjalnej dokumentacji Moodle: Import course data opisuje przenoszenie wybranych aktywności i zasobów między kursami, SCORM settings wyjaśnia dodawanie i konfigurację pakietów SCORM, a Upload users przedstawia zbiorcze tworzenie kont i zapisywanie użytkowników do kursów za pomocą pliku CSV. Informacje dotyczące integracji i synchronizacji użytkowników z Microsoft 365 opisano również w Microsoft 365 integration. 6. Co zrobić, gdy nie masz jeszcze żadnych materiałów do zaimportowania To najczęstszy scenariusz zaraz po wdrożeniu: platforma działa technicznie poprawnie, ale nie ma jeszcze co do niej wgrać. Firma dysponuje wiedzą – procedurami, prezentacjami, nagraniami – ale nie w formacie, który Moodle rozumie jako gotowy kurs. W takiej sytuacji są dwie drogi: Przygotowanie treści samodzielnie, z pomocą narzędzia AI4E-learning. Zespół wskazuje cel szkolenia i przekazuje posiadane materiały źródłowe (dokumenty, prezentacje, nagrania), a narzędzie generuje z nich strukturę kursu wraz z narracją audio i quizami, eksportując gotowy pakiet SCORM – dokładnie w formacie, który można zaimportować metodą opisaną wyżej. Zlecenie produkcji kursu zespołowi TTMS. Jeśli potrzebujecie pełnej oprawy graficznej, animacji czy wersji językowych, produkcja na zamówienie obejmuje cały proces: od scenariusza, przez grafikę i interakcje, po eksport i testy na platformie. Obie ścieżki prowadzą do tego samego efektu końcowego: pakietu gotowego do wgrania na platformę, którą już macie skonfigurowaną. 7. Podsumowanie Uruchomienie Moodle to ważny krok, ale dopiero wtedy zaczyna się praktyczna część całego procesu: przeniesienie istniejących kursów, uporządkowanie użytkowników i wypełnienie platformy treściami, z których pracownicy rzeczywiście będą korzystać. Punkt wyjścia w każdej organizacji może być inny. Czasem są to gotowe pakiety SCORM i kursy z poprzedniego LMS, a czasem prezentacje, dokumenty, procedury i wiedza ekspertów, które dopiero trzeba zamienić w szkolenia. Dlatego warto spojrzeć na Moodle jako na część większego ekosystemu nauki w organizacji. TTMS może wesprzeć cały proces: od analizy potrzeb, wdrożenia i konfiguracji Moodle, przez migrację oraz integracje, aż po przygotowanie i uruchomienie treści szkoleniowych. Jeśli materiały źródłowe już istnieją, AI4E-learning może dodatkowo pomóc przekształcić je w gotowe kursy i znacząco skrócić drogę od firmowej wiedzy do szkolenia dostępnego dla pracowników. Jeśli właśnie zastanawiacie się, jak przejść od wdrożonej platformy do działającego środowiska szkoleniowego, porozmawiajmy o Waszym punkcie wyjścia. Pomożemy dobrać zakres wdrożenia i kolejne kroki do materiałów, systemów oraz potrzeb Waszej organizacji. FAQ Czy import kursu do Moodle przenosi też wyniki i historię użytkowników? To zależy od sposobu przenoszenia kursu. Import treści z innego kursu Moodle nie obejmuje danych użytkowników, takich jak posty na forum. W przypadku przywracania kursu z kopii zapasowej zakres przenoszonych informacji zależy od zawartości backupu oraz dostępnych uprawnień. Jaki jest maksymalny rozmiar pliku SCORM, który można wgrać do Moodle? Zależy to od ustawień konkretnej instalacji – limitu wielkości przesyłanych plików skonfigurowanego na serwerze oraz w samym Moodle. W razie potrzeby limit ten można podnieść na poziomie konfiguracji platformy. Czy mogę zaimportować kurs z zupełnie innego systemu LMS, a nie tylko z Moodle? Zależy to od tego, w jakim formacie system źródłowy eksportuje dane. Jeśli udostępnia pakiet SCORM, można go zaimportować jako aktywność w kursie Moodle. Pełne przeniesienie struktury kursu, ról i danych z innego LMS to zwykle osobny projekt migracyjny, wymagający wcześniejszego ustalenia zakresu. Co zrobić, jeśli import kończy się błędem? Przyczyn może być wiele, od limitów wielkości plików i konfiguracji środowiska po problemy ze zgodnością przy przywracaniu kopii kursów. W takim przypadku warto przeanalizować konkretny komunikat błędu i konfigurację środowiska Moodle. Czy zaimportowany pakiet SCORM da się później edytować bezpośrednio w Moodle? Nie – pakiet SCORM jest zamkniętą paczką treści i Moodle traktuje go jako gotowy plik do odtworzenia, a nie edytowalny materiał. Aby wprowadzić zmiany, trzeba zmodyfikować kurs w narzędziu, w którym powstał (np. w AI4E-learning albo innym autorskim narzędziu), wyeksportować go ponownie i zastąpić poprzednią wersję aktywności w Moodle.
Czytaj
ChatGPT dla usług finansowych: co daje połączenie GPT z profesjonalnymi źródłami danych?
10 września 2026 r. OpenAI ogłosiło ChatGPT for Financial Services, rozwiązanie łączące GPT-6 Astra z profesjonalnymi źródłami danych finansowych i narzędziami do przygotowywania analiz. Produkt powstał we współpracy z Morgan Stanley i Evercore. Jest skierowany do instytucji finansowych, a na początek ma wspierać pracę w bankowości inwestycyjnej i analizie akcji. Zespoły analityczne mogą dzięki niemu wyszukiwać dane, wykonywać obliczenia i przygotowywać materiały dla klientów w jednym miejscu. To szansa na skrócenie czasu poświęcanego na zbieranie informacji i przenoszenie ich między narzędziami. Z tego artykułu dowiesz się: jakie dane i funkcje oferuje ChatGPT for Financial Services, jak może wyglądać przygotowanie analizy spółki z pomocą GPT, dlaczego trzeba sprawdzać sposób obliczania wskaźników i źródła danych, na których etapach potrzebna jest kontrola analityka, jak ocenić, czy wdrożenie opłaca się firmie. Jak ChatGPT for Financial Services wspiera pracę analityka? W materiałach OpenAI oraz dostawców danych opisano kilka konkretnych zastosowań: Porównywanie spółek. Daloopa (dostawca danych finansowych o spółkach) udostępnia wybrane dane i wskaźniki, które mogą posłużyć do zestawienia wyników przedsiębiorstw. Odwołania do źródeł pomagają sprawdzić pochodzenie liczb. Wyszukiwanie firm spełniających określone kryteria. Daloopa opisuje też wyszukiwanie spółek według rodzaju działalności lub obszaru geograficznego. Takie zestawienie może być punktem wyjścia do dalszej analizy rynku. Przygotowywanie materiałów dla klientów. OpenAI opisuje tworzenie modeli wyceny, not analitycznych i prezentacji z wykorzystaniem firmowych szablonów do programów Excel, Word i PowerPoint. W ChatGPT for Financial Services można korzystać z wybranych danych udostępnianych przez Daloopa, PitchBook, LSEG News i Crunchbase. OpenAI pracuje również nad integracjami, dzięki którym instytucje będą mogły korzystać z danych dostępnych w ramach już wykupionych abonamentów. Prace obejmują m.in. S&P Capital IQ, LSEG, MSCI, Dow Jones Factiva i Moody’s. Od danych do analizy spółki: pięć etapów pracy Prześledźmy przygotowanie porównania dwóch przedsiębiorstw przemysłowych przed spotkaniem z klientem. Analityk ma ocenić rentowność, wyjaśnić istotne różnice i przygotować krótką notę z tabelą wyników. Na fikcyjnych danych pokażemy, co warto sprawdzić podczas pilotażu: od doboru informacji po zatwierdzenie gotowego materiału. 1. Ustalenie pytania i zakresu porównania Najpierw ustalamy, jaki okres chcemy porównać: ostatni pełny rok, półrocze czy ostatnie dwanaście miesięcy. Sprawdzamy też, czy liczby dotyczą całej grupy kapitałowej, czy pojedynczej spółki, w jakiej walucie je podano i jak obliczono poszczególne wskaźniki. W naszym przykładzie korzystamy ze skonsolidowanych danych obu grup kapitałowych za ten sam rok kalendarzowy. Kwoty podajemy w milionach złotych. Przed porównaniem wyników trzeba sprawdzić daty rozpoczęcia i zakończenia okresów raportowania. Jedna firma może kończyć rok obrotowy w grudniu, a druga w marcu. Na takie różnice zwraca uwagę również dokumentacja bazy EDGAR prowadzonej przez amerykańską SEC. Analityk musi wtedy zdecydować, jak uwzględnić przesunięcie i czy potrzebuje dodatkowych danych. Przyjęte zasady warto zapisać w instrukcji dla AI i dołączyć do gotowej analizy. Dzięki temu model otrzyma jasne wytyczne, a osoba sprawdzająca wynik będzie wiedziała, jakie dane porównano i dlaczego. 2. Zebranie danych i wskazanie ich źródeł Przy każdej ważnej liczbie warto zapisać, jakiej spółki i okresu dotyczy, w jakich jednostkach ją podano oraz jak została obliczona. Do tego potrzebny jest odnośnik do konkretnej tabeli lub objaśnienia w raporcie. Zachowanie dokumentu źródłowego i daty jego pobrania ułatwi późniejsze sprawdzenie lub aktualizację analizy. Według opisu OpenAI ChatGPT for Financial Services pozwala dotrzeć do konkretnych tabel i fragmentów dokumentów, wyróżniając informacje wykorzystane w analizie. W naszym przykładzie porównujemy EBITDA, czyli wynik przed odsetkami, podatkiem dochodowym i amortyzacją. Osoba sprawdzająca analizę powinna móc przejść od podanej wartości do raportu spółki i sprawdzić sposób jej obliczenia. Dzięki temu sprawdzi również, czy wynik dotyczy właściwego okresu i części działalności. 3. Uzgodnienie definicji przed porównaniem marż Spółki mogą publikować skorygowaną EBITDA, przy której obliczaniu wyłączają wybrane koszty. Takie korekty zwiększają wartość wskaźnika. Dlatego przed porównaniem ich rentowności trzeba sprawdzić, jakie korekty zastosowano. Na różnice w sposobie obliczania wskaźników przez poszczególne firmy zwraca uwagę również amerykańska SEC. Przyjrzyjmy się dwóm fikcyjnym spółkom. Przyjmujemy, że obie spółki obliczają EBITDA przed korektami według tych samych zasad. Spółka A dodaje następnie do tego wyniku 20 mln zł kosztów, które wyłącza przy obliczaniu skorygowanej EBITDA. W rezultacie wskaźnik rośnie ze 120 do 140 mln zł. W spółce B takie koszty nie występują, więc wynik pozostaje bez zmian. Przykład ilustracyjny. Dane skonsolidowane za ten sam rok kalendarzowy. Kwoty podano w mln zł. Pozycja Spółka A Spółka B Przychody 1 000 800 EBITDA przed korektą 120 104 Koszty wyłączone przy obliczaniu skorygowanej EBITDA 20 0 Skorygowana EBITDA 140 104 Marża EBITDA przed korektą 12% 13% Marża skorygowanej EBITDA 14% 13% Po korekcie marża spółki A wynosi 14% i przewyższa marżę spółki B, która wynosi 13%. Przed korektą to spółka B ma wyższą marżę: 13% wobec 12%. W tym przykładzie sposób uwzględnienia kosztów decyduje o tym, która spółka ma wyższą marżę EBITDA. Analityk powinien więc sprawdzić, jakie koszty składają się na korektę w wysokości 20 mln zł i czy występowały również w poprzednich latach. Na tej podstawie ocenia, czy wyłączenie tych kosztów jest uzasadnione w przygotowywanej analizie. Może też pokazać oba warianty i wyjaśnić klientowi, skąd bierze się różnica. AI może pomóc zebrać dane i przeliczyć marże, a ekspert ocenia zasadność korekty i jej wpływ na wnioski. 4. Sprawdzenie obliczeń w arkuszu W naszym przykładzie wystarczy podzielić EBITDA przez przychody: 120 ÷ 1 000 daje marżę 12%, a 140 ÷ 1 000 daje 14%. Bardziej złożone analizy mogą wymagać przeliczenia walut, dopasowania okresów raportowania czy przygotowania kilku wariantów prognozy. Osoba sprawdzająca wynik powinna móc prześledzić każdy z tych kroków. Dlatego warto poprosić AI o arkusz, w którym dane źródłowe, założenia i formuły są wyraźnie rozdzielone. Analityk może wtedy sprawdzić rachunki i zobaczyć, jak zmiana jednej wartości wpływa na wynik. Aby sprawdzić działanie arkusza, można testowo zmniejszyć korektę z 20 do 10 mln zł. Skorygowana EBITDA spółki A powinna wtedy wynieść 130 mln zł, a odpowiadająca jej marża 13%. Po takiej zmianie trzeba również sprawdzić tabelę porównawczą i opis wyników. Obie spółki miałyby już taką samą marżę, więc wniosek o wyższej marży spółki A wymagałby aktualizacji. To prosty sposób, by ocenić, czy obliczenia i towarzyszący im tekst pozostają ze sobą zgodne. 5. Przygotowanie materiału dla klienta i sprawdzenie wniosków Gotową analizę można opracować w formacie używanym przez firmę. Według opisu OpenAI administrator może udostępnić zespołowi szablony do programów Excel, Word i PowerPoint, z których narzędzie korzysta przy tworzeniu dokumentów i prezentacji. W naszym przykładzie klient powinien otrzymać tabelę wyników oraz krótkie wyjaśnienie, jak korekta kosztów wpływa na porównanie marż. Ekspert sprawdzający materiał ocenia, czy wnioski zgadzają się z obliczeniami i odpowiadają na pytanie klienta. Jeśli coś wymaga doprecyzowania, może poprosić o dodatkowe wyjaśnienie lub kolejny wariant analizy. Pomiar czasu pracy powinien obejmować również sprawdzenie materiału i wprowadzenie poprawek przed jego zatwierdzeniem. Jak chronić dane i zachować historię pracy nad analizą? Przygotowując analizę dla klienta, zespół może korzystać z publicznych raportów, płatnych baz i poufnych dokumentów. Trzeba ustalić, kto ma dostęp do tych informacji, gdzie będą przechowywane i komu można przekazać gotowy materiał. Według dokumentacji bezpieczeństwa ChatGPT Work dane biznesowe są szyfrowane i domyślnie nie służą do trenowania modeli. Czas ich przechowywania, miejsce przetwarzania oraz zakres zapisywanej historii działań zależą od ustawień i podłączonych usług. Przed wdrożeniem trzeba sprawdzić, które działania użytkowników i narzędzi są zapisywane w rejestrach oraz które z tych zapisów można wyeksportować. Podczas pilotażu warto zachować dokumenty źródłowe, kolejne wersje arkusza oraz gotowy materiał z informacją, kto i kiedy go zatwierdził. Następnie trzeba sprawdzić, czy zgromadzona dokumentacja pozwala odtworzyć obliczenia i prześledzić zatwierdzenie analizy. Osobno trzeba zweryfikować, czy rejestry systemowe pozwalają prześledzić działania użytkowników i narzędzi w zakresie wymaganym przez firmę. Jak ocenić, czy wdrożenie się opłaca? Na początek warto wybrać zadanie, które zespół wykonuje regularnie, np. aktualizację porównania spółek po publikacji wyników kwartalnych. Przed testem trzeba zmierzyć czas wykonania takiej analizy dotychczasową metodą i ustalić wymagania dotyczące jej jakości. Te wyniki posłużą do porównania pracy z wykorzystaniem AI. Do czasu przygotowania analizy trzeba doliczyć czas potrzebny na jej sprawdzenie i wprowadzenie poprawek. OpenAI zwraca na to uwagę w materiale o ocenie korzyści z AI, zalecając również uwzględnienie kosztów wdrożenia i późniejszego korzystania z narzędzia. W praktyce warto porównać: Miernik Czego się dowiemy? Czas od rozpoczęcia zadania do zatwierdzenia analizy Czy klient szybciej otrzymuje gotowy materiał? Uwzględniamy też oczekiwanie między etapami. Łączny czas pracy analityka i osoby sprawdzającej Czy zespół poświęca mniej godzin na przygotowanie, kontrolę i poprawki? Liczba błędów wpływających na wynik lub wnioski Czy jakość analizy spełnia te same wymagania co przy dotychczasowym sposobie pracy? Poprawność i kompletność odwołań do źródeł Czy można sprawdzić pochodzenie najważniejszych liczb i informacji? Czas aktualizacji analizy Jak sprawnie można uwzględnić nowe dane i poprawić zależne od nich obliczenia oraz wnioski? Koszt jednej zatwierdzonej analizy Ile kosztuje gotowy materiał po uwzględnieniu pracy zespołu, narzędzia, danych oraz przypadającej na analizę części kosztów wdrożenia i utrzymania? Test powinien objąć kilka zadań o różnym poziomie trudności. Zasady oceny ustalamy przed jego rozpoczęciem. Osoba wykonująca tę samą analizę po raz drugi zna już dane i część odpowiedzi, co może skrócić czas pracy. Dlatego warto wykorzystać porównywalne zadania i zmieniać kolejność pracy z AI oraz dotychczasową metodą. Jeśli AI pozwoli zaoszczędzić czas, warto sprawdzić, jak zespół go wykorzystał. Być może przygotował więcej analiz, szybciej odpowiedział klientom lub ograniczył nadgodziny. W ocenie wdrożenia warto osobno pokazać, jak wykorzystano zaoszczędzony czas oraz czy i o ile zmniejszyły się wydatki firmy. Kiedy warto rozpocząć pilotaż? Pilotaż warto rozważyć, jeśli zespół regularnie zbiera dane z wielu źródeł i aktualizuje podobne analizy. Do testu można wybrać zadanie, które zajmuje analitykom dużo czasu, np. porównywanie danych z raportów spółek. Trzeba też wskazać osobę odpowiedzialną za pilotaż oraz ekspertów, którzy sprawdzą wyniki. Jeśli zespół sporadycznie analizuje kilka raportów rocznych, warto sprawdzić, czy wystarczą narzędzia już dopuszczone do użytku w firmie. Tam, gdzie pobieranie danych i obliczenia są zautomatyzowane, trzeba wskazać konkretne zadanie, które nowe narzędzie mogłoby usprawnić. OpenAI udostępnia produkt instytucjom finansowym spełniającym warunki dostępu i kieruje zainteresowane firmy do działu sprzedaży. Cenę, szczegółowe warunki oraz możliwość korzystania z usługi przez daną instytucję w Polsce trzeba potwierdzić u dostawcy. Informacje o dostępności. Decyzję o wdrożeniu warto oprzeć na wynikach pilotażu: jakości analiz, czasie ich przygotowania i sprawdzenia oraz całkowitym koszcie pracy. Test pokaże też, czy narzędzie zapewnia dostęp do danych potrzebnych zespołowi. Chcesz sprawdzić, gdzie AI może usprawnić pracę analityków w Twojej organizacji? Porozmawiaj z zespołem TTMS o wyborze zadania do pilotażu, połączeniu potrzebnych źródeł danych i sposobie oceny wyników. Czym ChatGPT for Financial Services różni się od analizowania raportów w ChatGPT? ChatGPT for Financial Services zapewnia dostęp do wybranych profesjonalnych danych finansowych bezpośrednio w narzędziu. Umożliwia też odwoływanie się do konkretnych tabel i fragmentów dokumentów oraz przygotowywanie materiałów według firmowych szablonów. Przy ocenie przydatności dla zespołu warto sprawdzić, czy dostępne źródła obejmują potrzebne spółki, okresy i wskaźniki. Czy ChatGPT for Financial Services wymaga osobnych abonamentów na dane finansowe? Możliwość przygotowania takiej analizy zależy od dostępności danych konkretnych spółek. Warto sprawdzić, czy narzędzie udostępnia ich sprawozdania, potrzebne wskaźniki i dane historyczne. Sam komunikat premierowy nie potwierdza pełnego pokrycia GPW. Przydatność rozwiązania najlepiej ocenić na kilku spółkach, które zespół regularnie analizuje. Co zrobić, gdy dane z ChatGPT różnią się od wartości w raporcie spółki? Najpierw trzeba porównać źródła, okresy raportowania, jednostki i definicje wskaźników. Różnica może wynikać np. z wykorzystania danych jednostkowych zamiast skonsolidowanych albo z uwzględnienia korekt EBITDA. Warto również sprawdzić, czy spółka opublikowała zaktualizowany raport. Analityk powinien wyjaśnić rozbieżność i zapisać, którą wartość przyjął oraz z jakiego powodu. Jak uzyskać dostęp do ChatGPT for Financial Services i sprawdzić jego cenę? OpenAI kieruje zainteresowane instytucje finansowe do działu sprzedaży lub opiekuna klienta. W rozmowie należy potwierdzić warunki dostępu, cenę, zakres danych oraz dostępność usługi dla danej instytucji w Polsce. Komunikat premierowy nie zawiera publicznego cennika.
Czytaj
Jak automatyzować testy – najlepsze praktyki w 2026 roku
Cykl życia oprogramowania stale przyspiesza. Zespoły deweloperskie wdrażają zmiany coraz częściej, a od QA oczekuje się szybkiego dostarczania informacji zwrotnej bez kompromisów w obszarze jakości. W takich realiach automatyzacja testów nie jest już przewagą konkurencyjną, lecz standardowym elementem procesu wytwarzania oprogramowania. Sama liczba testów automatycznych nie gwarantuje jednak lepszego pokrycia, szybszych wdrożeń ani większej stabilności produktu. Wiele organizacji przekonuje się, że rozbudowywanie zestawów testowych bez odpowiedniej strategii prowadzi do rosnących kosztów utrzymania, problemów z niezawodnością oraz coraz wolniejszego procesu dostarczania zmian. Najbardziej efektywne zespoły traktują automatyzację jako integralną część procesu QA i software delivery. Obejmuje to nie tylko tworzenie testów, ale również ich odpowiednią selekcję, wybór narzędzi i frameworków, integrację z CI/CD, regularne utrzymanie oraz świadome zarządzanie kodem automatyzacji. W tym artykule przedstawiamy najważniejsze praktyki, które pomagają budować skalowalną i łatwą w utrzymaniu automatyzację testów w 2026 roku. 1. Dlaczego najlepsze praktyki automatyzacji testów mają kluczowe znaczenie w 2026 roku? Współczesne aplikacje coraz częściej opierają się na zintegrowanych usługach, dynamicznie zmieniających się interfejsach oraz coraz krótszych cyklach delivery. Testy automatyczne obejmują dziś nie tylko aplikacje webowe, ale również aplikacje mobilne, API, integracje oraz krytyczne ścieżki użytkownika. W efekcie równie ważne jak liczba testów w suite staje się sposób planowania, budowania i utrzymywania automatyzacji. Bez jasno określonych standardów automatyzacja bardzo szybko może stać się dodatkowym źródłem problemów zamiast wsparciem dla procesu delivery. Niestabilne testy spowalniają pipeline’y CI/CD, nieaktualne skrypty przestają odzwierciedlać bieżące wymagania biznesowe, a duplikowanie pokrycia testowego zwiększa czas wykonywania testów i koszty utrzymania bez realnej poprawy jakości. Jak opisaliśmy w naszym artykule o AI end-to-end testing, skuteczna i skalowalna automatyzacja wymaga jasno określonej odpowiedzialności za testy, pełnej traceability, regularnego utrzymania oraz świadomego powiązania wymagań biznesowych z celami testów, ich wykonaniem i uzyskiwanymi wynikami. To właśnie te elementy pozwalają budować automatyzację, która wspiera rozwój produktu zamiast generować dodatkowy dług technologiczny. 2. Jak decydować, które testy warto automatyzować? Nie każdy test powinien trafić do zestawu testów automatycznych. Skuteczna automatyzacja wymaga uporządkowanego podejścia, które pozwala identyfikować scenariusze przynoszące realną wartość biznesową, zamiast generować dodatkowe koszty utrzymania. 2.1 Oceniaj testy pod kątem częstotliwości, stabilności i kosztów Praktycznym sposobem wyboru testów do automatyzacji jest ocena każdego scenariusza pod kątem kilku kluczowych kryteriów: częstotliwości wykonywania, stabilności testowanej funkcjonalności, znaczenia biznesowego oraz nakładu pracy potrzebnego do wdrożenia i utrzymania automatyzacji. Najlepszymi kandydatami są zwykle powtarzalne scenariusze z jasno określonym oczekiwanym wynikiem, stabilnymi warunkami początkowymi, wiarygodnymi danymi testowymi oraz istotnym wpływem na jakość wydań. Sam fakt częstego wykonywania testu nie jest jednak wystarczającym argumentem. Warto również ocenić, czy scenariusz można wykonywać w sposób powtarzalny oraz czy jego rezultat można zweryfikować bez subiektywnej oceny. 2.2 Testy wymagające oceny człowieka pozostaw manualne Exploratory testing, ocena pierwszych doświadczeń użytkownika, analiza aspektów wizualnych czy scenariusze wymagające interpretacji ze strony testera zwykle lepiej sprawdzają się jako testy manualne. Próba ich automatyzacji często eliminuje elastyczność i obserwacje, które stanowią ich największą wartość. Jednocześnie rzadkie występowanie danego scenariusza nie oznacza automatycznie, że nie warto go automatyzować. Jeśli ewentualna awaria mogłaby zakłócić krytyczny proces biznesowy, zagrozić integralności danych lub generować wysokie ryzyko operacyjne, automatyzacja może być w pełni uzasadniona. Ostateczna decyzja powinna uwzględniać zarówno częstotliwość wykonywania testu, jak i jego wpływ na biznes. 2.3 Priorytetowo traktuj krytyczne ścieżki użytkownika Po odrzuceniu scenariuszy, które nie nadają się do automatyzacji, warto uszeregować pozostałe testy według ich znaczenia biznesowego oraz ryzyka regresji. Najczęściej priorytet otrzymują procesy związane z logowaniem, realizacją zakupów, dostępem do kont użytkowników, akceptacjami oraz kluczowymi procesami transakcyjnymi. Problemy w tych obszarach mogą bezpośrednio uniemożliwić użytkownikom korzystanie z najważniejszych funkcji systemu. Rozpoczęcie automatyzacji od takich scenariuszy pozwala zabezpieczyć najbardziej krytyczne elementy aplikacji już na wczesnym etapie. Testy dotyczące mniej istotnych funkcjonalności można dodawać stopniowo, gdy korzyści wynikające z automatyzacji uzasadniają koszty ich wdrożenia i późniejszego utrzymania. 3. Dopasuj strategię automatyzacji do aplikacji i kompetencji zespołu Po wytypowaniu testów, które warto zautomatyzować, kolejnym krokiem jest wybór podejścia najlepiej dopasowanego do aplikacji, sposobu dostarczania oprogramowania oraz kompetencji zespołu. Decyzja powinna uwzględniać nie tylko szybkość wykonywania testów, ale również łatwość utrzymania, poziom kontroli technicznej, dostępność rozwiązania dla zespołu QA oraz sposób integracji automatyzacji z istniejącym procesem developmentu. 3.1 Korzystaj z Test Pyramid, aby zachować równowagę między szybkością i pokryciem testowym Test Pyramid nadal pozostaje jednym z najskuteczniejszych modeli projektowania automatyzacji. Jej podstawę stanowią szybkie unit tests, wyższy poziom zajmują integration tests oraz service-level tests, a na szczycie znajduje się mniejsza liczba end-to-end tests weryfikujących kompletne ścieżki użytkownika. Dokładne proporcje pomiędzy poszczególnymi warstwami powinny wynikać z architektury aplikacji oraz obszarów największego ryzyka. System oparty na wielu usługach może wymagać większego nacisku na testy integracyjne, podczas gdy aplikacja biznesowa często potrzebuje szerszego pokrycia kluczowych procesów za pomocą testów end-to-end. Celem jest wykrywanie problemów na możliwie najniższym poziomie przy jednoczesnym zachowaniu wystarczającej liczby testów end-to-end, które potwierdzają poprawne działanie najważniejszych ścieżek użytkownika. 3.2 Wybierz między code-based, codeless i podejściem hybrydowym Code-based automation zapewnia pełną kontrolę nad architekturą testów, integracjami, reużywalnymi komponentami oraz standardami obowiązującymi w repozytorium. Takie podejście najlepiej sprawdza się w zespołach posiadających silne kompetencje techniczne, bardziej złożone wymagania testowe lub rozwinięte frameworki automatyzacji. Codeless oraz low-code automation ograniczają ilość kodu potrzebnego do definiowania typowych scenariuszy testowych. Dzięki temu automatyzacja staje się bardziej dostępna dla testerów manualnych i ekspertów biznesowych. Warto jednak zwrócić uwagę na to, jak dana platforma radzi sobie z bardziej złożoną logiką, utrzymaniem testów, version control oraz ownership automatyzacji. Coraz więcej organizacji wybiera model hybrydowy, który łączy prostotę definiowania testów z elastycznością klasycznej automatyzacji. Testerzy QA mogą definiować i weryfikować założenia testów, podczas gdy Automation Engineerowie odpowiadają za standardy techniczne oraz utrzymanie generowanego kodu. Takie podejście ogranicza liczbę przekazań pomiędzy zespołami bez zamykania się na jedno, proprietarne rozwiązanie. 3.3 Oceń dopasowanie technologiczne i długoterminowe utrzymanie Wybór odpowiedniej metodologii powinien wynikać z charakteru testowanego systemu oraz tego, kto będzie odpowiadał za utrzymanie automatyzacji w dłuższej perspektywie. Złożone procesy backendowe i integracje usług często wymagają pełnej kontroli technicznej, podczas gdy powtarzalne ścieżki użytkownika w aplikacjach webowych mogą być dobrym kandydatem do wykorzystania codeless automation. Warto również odpowiedzieć sobie na kilka praktycznych pytań: Gdzie będą uruchamiane wygenerowane testy? Czy ich kod będzie dostępny w istniejącym repozytorium? W jaki sposób wyniki testów wrócą do procesu QA? Czy wybrane rozwiązanie spełnia wymagania organizacji dotyczące bezpieczeństwa i deploymentu? Popularność narzędzia ma znacznie mniejsze znaczenie niż jego dopasowanie do architektury aplikacji, kompetencji zespołu, modelu governance oraz kosztów długoterminowego utrzymania automatyzacji. 4. Projektuj automatyzację z myślą o łatwym utrzymaniu Sposób projektowania testów i frameworków ma ogromny wpływ na długoterminową stabilność automatyzacji, niezależnie od wykorzystywanych narzędzi. Dobrze zaprojektowana automatyzacja oddziela warstwę techniczną od logiki biznesowej testu, wykorzystuje spójne standardy pracy z repozytorium i ułatwia analizę oraz naprawę błędów. 4.1 Korzystaj ze stabilnych locatorów Locatory bazujące na pozycji elementu na stronie, dynamicznie generowanych identyfikatorach lub rozbudowanych ścieżkach DOM często prowadzą do niestabilnych testów po zmianach w interfejsie. Tam, gdzie to możliwe, warto wykorzystywać selektory oparte na stabilnych atrybutach, takich jak dedykowane identyfikatory testowe, role dostępności (accessibility roles), etykiety lub inne elementy odpowiadające rzeczywistym interakcjom użytkowników z aplikacją. Dobry locator powinien być zarówno stabilny, jak i wystarczająco precyzyjny, aby jednoznacznie wskazywać właściwy element. Celem nie jest całkowite wyeliminowanie maintenance, ale ograniczenie błędów wynikających ze zmian technicznych niezwiązanych z faktycznie testowaną funkcjonalnością. 4.2 Wykorzystuj reużywalne wzorce projektowe Wzorce takie jak Page Object Model (POM) pozwalają oddzielić interakcje z aplikacją od logiki biznesowej weryfikowanej przez testy. Dzięki temu zmiana elementu interfejsu wymaga aktualizacji jednego komponentu zamiast modyfikacji dziesiątek testów. W zależności od projektu warto również korzystać z takich elementów jak component objects, współdzielone fixtures, funkcje pomocnicze, reużywalne akcje czy własne warstwy abstrakcji. Kluczowe znaczenie ma konsekwentne stosowanie wybranych wzorców w całym repozytorium. 4.3 Twórz jednoznaczne asercje Każdy test automatyczny powinien zawierać jasno określony i możliwy do zweryfikowania oczekiwany rezultat. Scenariusz, który wykonuje serię kroków bez sprawdzenia efektu końcowego, może zakończyć się statusem „passed”, mimo że testowany proces biznesowy nie działa poprawnie. Asercje powinny potwierdzać oczekiwane zachowanie aplikacji, a nie przypadkowe szczegóły implementacji. Jasno zdefiniowane oczekiwane rezultaty ułatwiają również review testów, diagnostykę błędów oraz traceability względem wymagań biznesowych. 4.4 Traktuj test data management jako osobny obszar Dane testowe powinny mieć jasno określonego właściciela oraz powtarzalny proces przygotowania. Tworzenie, inicjalizacja, współdzielenie, zabezpieczanie i czyszczenie danych testowych warto zaplanować już podczas projektowania testów, a nie dopiero po stworzeniu skryptów. Zespoły powinny również unikać ukrytych zależności od danych pozostawionych przez wcześniejsze wykonania testów. Przewidywalne dane testowe ułatwiają odtwarzanie błędów oraz ograniczają liczbę fałszywych wyników wynikających z nieaktualnych, niekompletnych lub niespójnych rekordów. 4.5 Dbaj o niezależność testów Testy automatyczne nie powinny zależeć od kolejności wykonywania innych testów. Każdy scenariusz powinien rozpoczynać się od znanego stanu systemu i samodzielnie przygotowywać warunki niezbędne do wykonania testu. Izolację można osiągnąć między innymi poprzez użycie fixtures, kontrolowane przygotowanie danych testowych, oddzielne konteksty przeglądarki, przygotowanie danych przez API, reset środowiska lub procedury cleanup. Awaria pojedynczego testu nie powinna powodować błędnych wyników w innych częściach test suite. 4.6 Stosuj spójne standardy repozytorium Kod automatyzacji powinien podlegać tym samym standardom jakościowym co pozostała część projektu. Spójne nazewnictwo, struktura katalogów, sposób wykorzystania fixtures, helperów, hooków, obsługa błędów, formatowanie kodu oraz zasady code review sprawiają, że zarówno ręcznie tworzone, jak i generowane testy są łatwiejsze do zrozumienia i utrzymania. Ma to szczególne znaczenie w projektach, w których część kodu automatyzacji jest generowana automatycznie. Wygenerowany kod powinien wpisywać się w istniejący framework i standardy repozytorium, zamiast tworzyć równoległą strukturę, którą zespół będzie musiał utrzymywać oddzielnie. 5. Integruj odpowiednie testy na właściwym etapie CI/CD Testy automatyczne przynoszą największą wartość wtedy, gdy są częścią pipeline’u CI/CD i dostarczają szybką oraz użyteczną informację zwrotną osobom odpowiedzialnym za wdrażane zmiany. Celem nie jest uruchamianie wszystkich testów po każdej modyfikacji kodu, lecz dopasowanie zakresu testowania do konkretnego etapu procesu delivery. 5.1 Dopasuj zakres testów do etapu pipeline’u Dobrze zaprojektowany pipeline pozwala zachować równowagę pomiędzy szybkością feedbacku a głębokością walidacji. Na wczesnych etapach zmianę mogą weryfikować szybkie unit tests oraz statyczna analiza kodu. Na etapie pull requestów lub merge requestów warto uruchamiać integration tests oraz odpowiednio dobrany fragment regression suite, który pozwala ocenić wpływ zmiany na szerszy obszar aplikacji. Bardziej rozbudowane testy regresyjne mogą być wykonywane po połączeniu zmian z główną gałęzią, przed wdrożeniem, według harmonogramu lub w sytuacjach, gdy poziom ryzyka uzasadnia szerszą walidację. Smoke tests pełnią inną funkcję. Ich zadaniem jest szybkie potwierdzenie, że wdrożona aplikacja działa, jest dostępna dla użytkowników i obsługuje najbardziej krytyczne ścieżki biznesowe. Powinny one uzupełniać testy regresyjne, a nie je zastępować. Struktura pipeline’u i oczekiwany czas wykonywania testów powinny być dostosowane do architektury aplikacji, infrastruktury, częstotliwości wydań oraz poziomu ryzyka biznesowego. Każdy zespół powinien zdefiniować własne quality gates, określające, jakie dowody jakości są wymagane przed przejściem do kolejnego etapu procesu. 5.2 Dobieraj testy na podstawie zmian i poziomu ryzyka Uruchamianie pełnego test suite po każdej zmianie w kodzie z czasem zaczyna wydłużać proces delivery. Bardziej efektywne podejście polega na wybieraniu testów na podstawie komponentów objętych zmianą, powiązanych wymagań biznesowych, krytycznych procesów, historii wcześniejszych uruchomień oraz znanych obszarów ryzyka. Proces selekcji testów powinien być transparentny. Zespół powinien rozumieć, dlaczego dany test został uwzględniony lub pominięty, a także mieć możliwość rozszerzenia zakresu walidacji, jeżeli analiza wpływu zmiany okaże się niepełna lub pojawią się nowe ryzyka. Ta warstwowa, oparta na ryzyku struktura jest też fundamentem, na którym opiera się selekcja i priorytetyzacja testów wspierana przez AI. Jeśli interesuje Cię, jak AI wpisuje się właśnie w ten etap pipeline’u, sprawdź nasz przewodnik AI w automatyzacji testów oprogramowania: przewodnik 2026. 5.3 Dostarczaj wyniki, które pomagają podejmować decyzje Wyniki testów powinny dostarczać znacznie więcej informacji niż jedynie status „passed” lub „failed”. Raport powinien wskazywać, który scenariusz zakończył się błędem, zawierać dane pozwalające przeprowadzić analizę problemu oraz zachowywać powiązanie z wymaganiem biznesowym, przypadkiem testowym, zmianą w kodzie i historią wykonania testu. Prezentowanie wyników bezpośrednio w pull requestach lub merge requestach pozwala zespołom developerskim analizować rezultaty automatyzacji równocześnie ze zmianami w kodzie. Z kolei przekazywanie wyników do narzędzi QA i systemów zarządzania wymaganiami zapewnia pełną traceability od wymagania biznesowego, przez implementację testu, aż po jego wykonanie. Takie podejście zamyka pętlę feedbacku i pozwala podejmować decyzje release’owe w oparciu o rzetelne dane, a nie domysły. 6. Traktuj utrzymanie testów jako ciągły proces Flaky tests mogą bardzo szybko podważyć zaufanie do automatyzacji. Gdy ten sam test raz przechodzi, a raz kończy się niepowodzeniem bez żadnej istotnej zmiany w aplikacji, zespoły zaczynają traktować wyniki jako szum informacyjny. Ponowne uruchomienie testu może tymczasowo odblokować pipeline, ale nie rozwiązuje rzeczywistego problemu. 6.1 Analizuj źródło problemu, a nie objawy Przyczyna występowania flaky tests może leżeć w kodzie testów, samej aplikacji, danych testowych, środowisku wykonawczym lub zewnętrznych zależnościach. Do najczęstszych powodów należą sztywne opóźnienia (fixed delays), brak odpowiedniej synchronizacji, niestabilne locatory, współdzielony stan pomiędzy testami, konfliktujące dane testowe, asynchroniczne działanie aplikacji, zmienność połączeń sieciowych oraz ograniczenia zasobów środowiska wykonawczego. Sposób rozwiązania problemu powinien odpowiadać jego źródłu. Problemy związane z timingiem często wymagają zastosowania warunkowych mechanizmów oczekiwania zamiast wydłużania opóźnień. Błędy wynikające ze współdzielonego stanu wymagają lepszej izolacji i kontrolowanego przygotowania danych testowych. Problemy z selektorami mogą wymagać bardziej stabilnych locatorów lub dodatkowych warstw abstrakcji. Natomiast błędy powodowane przez zależności zewnętrzne mogą wymagać wykorzystania mocków, kontrolowanych środowisk testowych lub innych metod ograniczających niepotrzebną zmienność. Zespoły powinny również gromadzić wystarczającą ilość informacji pozwalających odróżnić defekt aplikacji od błędu testu lub problemu środowiskowego. Trace execution, logi, screenshoty, nagrania, informacje o ruchu sieciowym, szczegóły środowiska oraz wskazanie kroku, na którym wystąpił błąd, znacząco ułatwiają analizę i odtwarzanie problemów występujących nieregularnie. 6.2 Regularnie przeglądaj i porządkuj test suite Testy automatyczne powinny być oceniane przez cały cykl życia produktu. Zmiany w aplikacji mogą sprawiać, że niektóre testy stają się zbędne, duplikują istniejące pokrycie lub tracą wartość biznesową. Utrzymywanie wszystkich testów bez wyjątku zwiększa czas wykonywania test suite i nakład pracy związany z maintenance, niekoniecznie poprawiając jakość release’ów. Dobrze zdefiniowany proces maintenance powinien obejmować przegląd flaky tests, usuwanie nieaktualnych scenariuszy, eliminowanie zduplikowanego pokrycia oraz ponowną ocenę testów, których wartość biznesowa lub stabilność techniczna uległy zmianie. Częstotliwość takich przeglądów powinna być dostosowana do wielkości test suite, częstotliwości wydań, poziomu ryzyka i skali zmian w produkcie. Każdy test po przeglądzie powinien mieć jasno określony dalszy los. Może zostać naprawiony, przepisany, przeniesiony do bardziej odpowiedniej warstwy testowania, czasowo wyłączony z przypisanym właścicielem lub usunięty, jeśli nie dostarcza już wartościowych informacji. 6.3 Monitoruj kondycję automatyzacji i koszty utrzymania Sam pass rate nie wystarczy, aby ocenić kondycję automatyzacji. Zespoły powinny monitorować również powtarzalność błędów, częstotliwość ponownych uruchomień testów, czas wykonywania test suite, nakład pracy związany z maintenance, liczbę nieaktualnych testów, poziom zduplikowanego pokrycia oraz czas potrzebny na analizę i naprawę błędów. Takie wskaźniki pomagają odróżnić rozrastający się zestaw automatyzacji od automatyzacji, którą można skutecznie utrzymywać w długim okresie. Dodawanie kolejnych testów zwiększa wartość tylko wtedy, gdy zespół rozumie wyniki, potrafi utrzymywać testy i ufa informacjom dostarczanym przez każde wykonanie. Równie ważna jest traceability zmian w automatyzacji. Zespół powinien mieć wgląd w to, co zostało zmienione, dlaczego test został zaktualizowany, jak przebiegał proces review oraz czy zmodyfikowany test nadal weryfikuje pierwotne wymaganie biznesowe. Podejście oparte na zarządzaniu pełnym cyklem życia automatyzacji opisaliśmy szerzej w naszym przewodniku dotyczącym najlepszych praktyk QA w testowaniu oprogramowania. 7. Traktuj kod automatyzacji tak jak kod produkcyjny Kod testów automatycznych powinien podlegać tym samym standardom co kod aplikacji. Testy wymagają jasno określonego ownership, kontroli wersji, spójnych zasad organizacji repozytorium, procesu review oraz quality gates. Bez tych praktyk automatyzacja z czasem staje się coraz trudniejsza do zrozumienia, rozwijania i utrzymywania. Ownership powinien obejmować zarówno warstwę biznesową, jak i techniczną. Specjaliści QA mogą odpowiadać za definiowanie scenariuszy, oczekiwanych rezultatów i zakresu pokrycia testowego, natomiast Automation Engineers lub developerzy powinni weryfikować, czy kod testów jest zgodny ze standardami projektu i może być utrzymywany w ramach istniejącego frameworka. Niezależnie od tego, czy testy są tworzone ręcznie, czy generowane przy wsparciu narzędzi automatyzujących, powinny trafiać do repozytorium poprzez standardowy proces pull request lub merge request. Osoby przeprowadzające review powinny mieć możliwość sprawdzenia, co dokładnie weryfikuje dany test, w jaki sposób komunikuje się z aplikacją, z jakich komponentów współdzielonych korzysta oraz czy nie wprowadza niestabilnych zależności lub zduplikowanego pokrycia testowego. Gdy dla organizacji istotne są kwestie ownership i przenośności rozwiązań, wygenerowane testy nie powinny pozostawać wyłącznie w zamkniętym, proprietarnym środowisku wykonawczym. Przechowywanie automatyzacji w repozytorium klienta zapewnia pełną widoczność zmian, możliwość przeprowadzenia review oraz objęcie testów tymi samymi zasadami governance, które obowiązują pozostałe zasoby projektu. Zespoły powinny również jasno określić, kto odpowiada za reakcję na sytuację, w której test staje się niestabilny lub nieaktualny. Wyraźnie zdefiniowany ownership pozwala uniknąć sytuacji, w której błędne testy pozostają nierozwiązane, ponieważ zespoły QA, developmentu i automatyzacji zakładają, że odpowiedzialność spoczywa po stronie kogoś innego. 8. Gdzie w tym procesie wpisuje się AI AI coraz częściej wspiera te praktyki — pomagając tworzyć przypadki testowe na podstawie wymagań, weryfikować proponowaną ścieżkę przed wygenerowaniem kodu czy wskazywać testy, które prawdopodobnie staną się niestabilne. To zagadnienie wykracza poza zakres praktyk opisanych powyżej i dotyczy raczej strategii, doboru narzędzi oraz governance, dlatego omawiamy je szczegółowo w osobnym artykule: AI w automatyzacji testów oprogramowania: przewodnik 2026. 9. Najczęstsze błędy w automatyzacji testów, których warto unikać Nawet dobrze zaprojektowana automatyzacja może z czasem tracić swoją wartość, jeśli zespoły podejmują niewłaściwe decyzje dotyczące zakresu testów, ownership czy utrzymania. Do najczęstszych błędów należą: Automatyzowanie wszystkich możliwych scenariuszy zamiast skupienia się na testach powtarzalnych, stabilnych i krytycznych z punktu widzenia biznesu. Traktowanie ponownego uruchamiania testów jako stałego rozwiązania problemu flaky tests zamiast analizowania rzeczywistych przyczyn ich niestabilności. Pozostawianie w test suite nieaktualnych lub zduplikowanych testów bez regularnych przeglądów. Wybór narzędzia wyłącznie na podstawie liczby funkcji, bez uwzględnienia integracji, utrzymania, wdrożeń, ownership kodu oraz dopasowania do kompetencji zespołu. Generowanie automatyzacji bez wcześniejszej weryfikacji, czy dany scenariusz faktycznie działa w testowanej aplikacji. Akceptowanie wygenerowanych testów bez sprawdzenia, czy odzwierciedlają rzeczywiste wymagania i oczekiwane zachowanie biznesowe. Przechowywanie automatyzacji wyłącznie w zamkniętym, proprietarnym środowisku, gdy organizacja wymaga przenośnego i podlegającego review kodu we własnym repozytorium. Zarządzanie testami poza standardowymi procesami version control, code review i quality gates w CI/CD. Brak jasno określonej odpowiedzialności za cel testu, jakość kodu oraz bieżące utrzymanie automatyzacji. Unikanie tych błędów wymaga czegoś więcej niż wdrożenia kolejnych narzędzi lub napisania większej liczby skryptów. Skuteczna automatyzacja opiera się na kontrolowanym procesie, który łączy wymagania biznesowe, projektowanie testów, wyniki wykonania, kod automatyzacji, review oraz maintenance w jeden spójny workflow. 10. Jak Qatana wykorzystuje najlepsze praktyki automatyzacji testów? Qatana łączy opisane wcześniej praktyki w ramach agentowej platformy do automatyzacji testów. Rozwiązanie przekształca wymagania zapisane w Jira lub GitLab w gotowe do automatyzacji przypadki testowe, weryfikuje proponowaną ścieżkę użytkownika poprzez wykonanie testu w Playwright, a następnie generuje standardowy kod Playwright dostarczany w formie gotowego do review merge requestu. Zespół QA zachowuje kontrolę nad celem i zakresem testu, podczas gdy część techniczna może zostać zweryfikowana przez inżynierów w ramach istniejącego procesu merge request review. Wyniki wykonania testów pozostają powiązane z wymaganiem, przypadkiem testowym oraz kodem, zapewniając pełną traceability w całym workflow. Qatana działa w pełni on-premise i wspiera wykorzystanie wybranego przez organizację modelu LLM, dzięki czemu kontekst projektu, wygenerowany kod oraz dane testowe pozostają w środowisku klienta. Umów demo i zobacz, jak Qatana zamienia wymagania biznesowe w automatyzację opartą na Playwright. 11. FAQ – Najczęściej zadawane pytania Jaką część test suite warto zautomatyzować? Nie istnieje jeden uniwersalny wskaźnik. W pierwszej kolejności warto automatyzować scenariusze stabilne, powtarzalne i krytyczne biznesowo, pozostawiając exploratory testing oraz testy wymagające oceny człowieka w obszarze testów manualnych. Jaka jest różnica między strategią automatyzacji a frameworkiem? Strategia automatyzacji określa, co, dlaczego i w jaki sposób powinno zostać zautomatyzowane oraz jak będzie mierzony sukces tych działań. Framework stanowi natomiast techniczną podstawę służącą do tworzenia, uruchamiania i utrzymywania testów automatycznych. Jak ocenić, czy ROI z automatyzacji jest dodatnie? Warto porównać czas i koszty zaoszczędzone dzięki automatyzacji z kosztami jej wdrożenia, wykonywania i utrzymania. Jeżeli nakład pracy związany z maintenance regularnie przewyższa uzyskiwane korzyści, należy ponownie ocenić dobór testów oraz przyjęte podejście do automatyzacji. Jaka jest najczęstsza przyczyna tego, że program automatyzacji „utyka” po pierwszym pilotażu? Zwykle nie jest to problem narzędziowy, tylko brak ciągłego ownership. Zespoły z sukcesem automatyzują pierwszą partię testów, ale bez zdefiniowanego cyklu utrzymania, jasno przypisanej odpowiedzialności za kod oraz procesu review w repozytorium, suite szybciej obrasta w niestabilne i nieaktualne testy, niż ktokolwiek zdąży je naprawić — a zaufanie do wyników automatyzacji spada.
CzytajZaufały nam największe światowe organizacje











Transition Technologies MS świadczy usługi informatyczne terminowo, o wysokiej jakości i zgodnie z podpisaną umową. Polecamy firmę TTMS jako godnego zaufania i rzetelnego dostawcę usług IT oraz partnera wdrożeniowego Salesforce.
TTMS od lat pomaga nam w zakresie konfiguracji i zarządzania urządzeniami zabezpieczającymi z wykorzystaniem różnych technologii. Ueługi świadczone przez TTMS są realizowane terminowo, i zgodnie z umową.
Już dziś możemy pomóc Ci rosnąć
Porozmawiajmy, jak możemy wesprzeć Twój biznes
Monika Radomska
Sales Manager